2 Validità e affidabilità
2.1 Introduzione a validità e affidabilità
Possiamo considerare gli strumenti di misurazione tutti precisi allo stesso modo?
La risposta a questa domanda retorica è, chiaramente, no. Sappiamo bene che ogni strumento di misurazione (non solo psicologica) può essere più o meno preciso, e ci regoliamo di conseguenza. Un geometra che deve rilevare un muro non si affida a un metro pieghevole, ma a un rilevatore laser. Per misurare con esattezza la temperatura di un bambino è preferito comunque il termometro ascellare, scomodo ma preciso, al termometro auricolare, che fornisce una lettura più rapida ma spesso considerata meno stabile. Gli esempi si potrebbero moltiplicare, ma il principio resta lo stesso: sappiamo che gli strumenti di misurazione possono avere diversi livelli di precisione e quando una misurazione è rilevante, scegliamo gli strumenti che riteniamo più adeguati.
Su questo semplice principio si fonda il presente capitolo. Anche i test neuropsicologici sono strumenti di misurazione, e dovremmo porre attenzione alla loro precisione. Nell’ambito degli strumenti costruiti secondo la Teoria Classica dei Test, la bontà di uno strumento è espressa principalmente da due proprietà: validità e affidabilità.
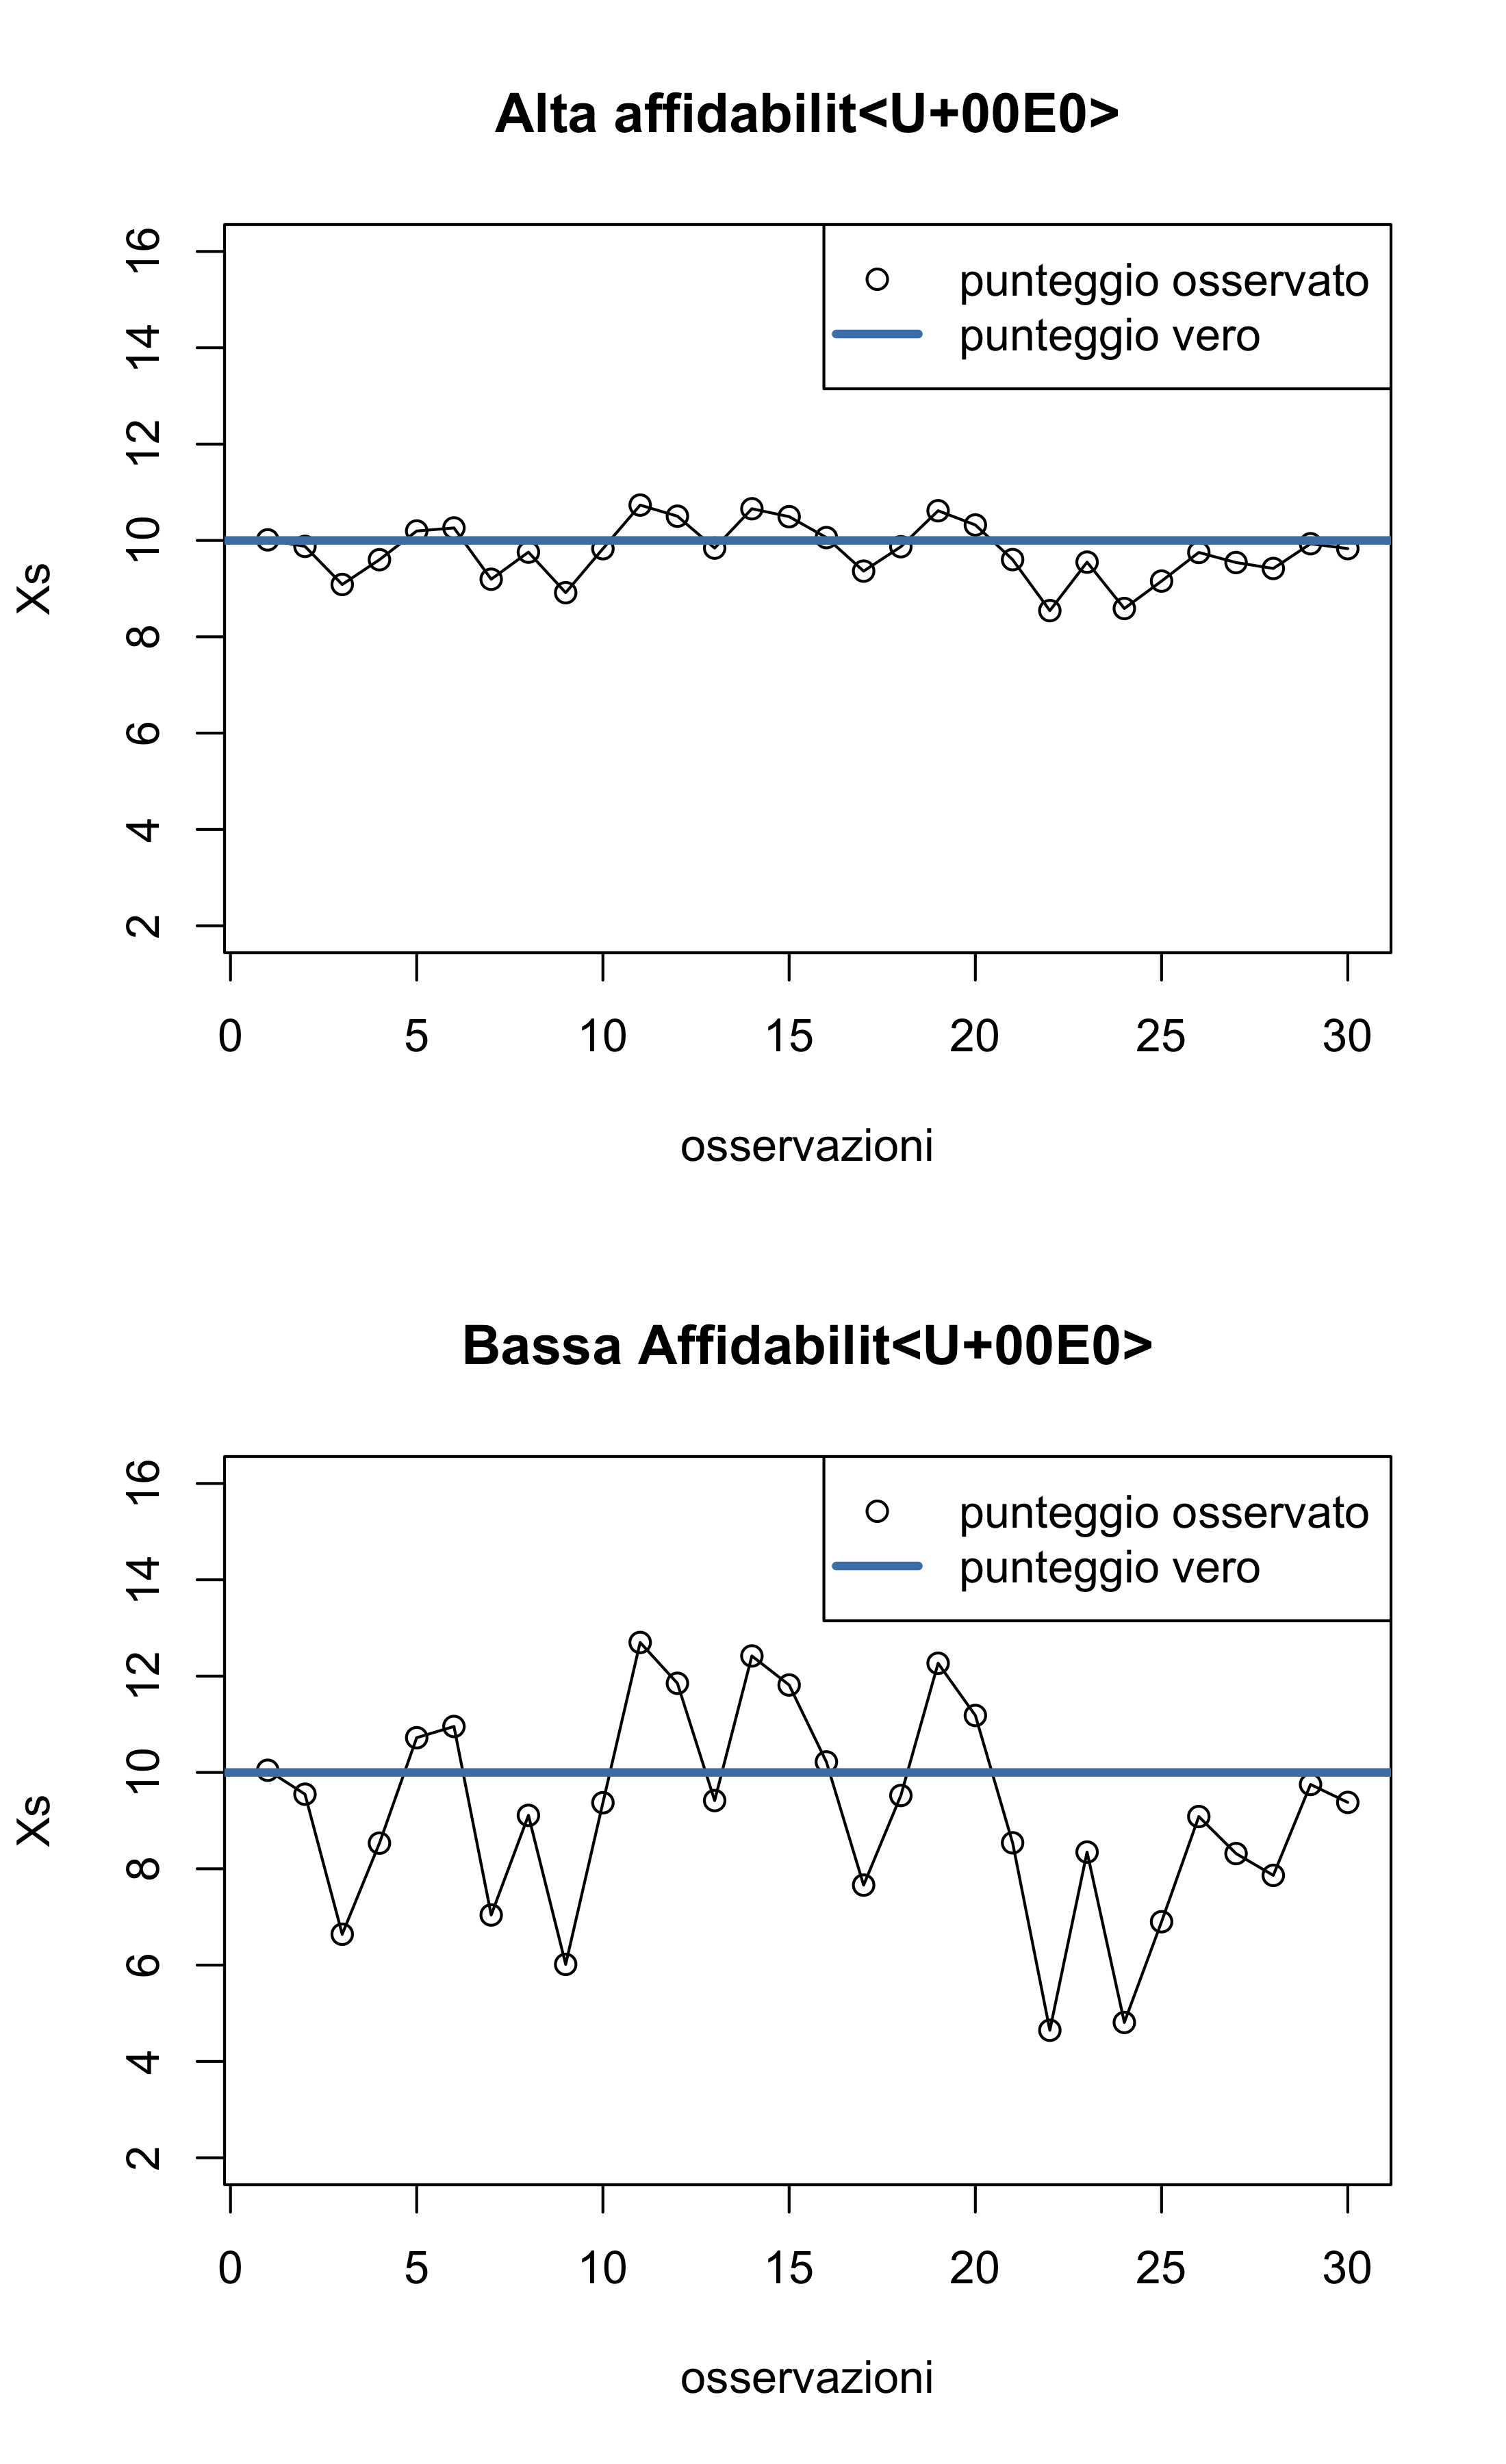
Entrambe sono direttamente collegate alla formula cardine \(X = T + E\), (vedi il paragrafo Teoria Classica dei Test nel capitolo precedente). In sintesi, la validità risponde alla domanda “cosa stiamo misurando?”, cioè se il punteggio vero \(T\) rifletta effettivamente il costrutto che il test intende misurare, mentre l’affidabilità risponde a “quanto precisamente siamo misurando?”, cioè quanto è piccola la componente d’errore \(E\) rispetto al punteggio osservato \(X\). Nei prossimi paragrafi tratteremo prima la validità e, di seguito, l’affidabilità.
Una domanda che automaticamente verrebbe da porsi è: come faccio a capire se il mio test è sufficientemente valido o sufficientamente affidabile per poterlo utilizzare? Questa domanda non ha una risposta semplice e non esistono dei criteri unanimamente condivisi. Per ogni tipo di validità e affidabilità, se pertinente sono riportate alcune soglie minime indicative di quegli indici che sono utilizzati per valutarle (la fonte principale è Slick, cap. 1 in Spreen & Strauss, 2006). Tali soglie sono appunto da considerare solo come “indicative”. Come usare i valori di affidabilità e validità per selezionare un test è trattato in dettaglio alla fine nel capitolo, nel paragrafo Nella pratica clinica: Come usare affidabilità e validità per scegliere i test.
2.2 Come leggere questo capitolo
Questo capitolo sarà denso di classificazioni e di definizioni. Ciò riflette la complessità e le diverse sfaccettatture che caratterizzano validità e affidabilità. Nel presentare i concetti il capitolo adotta una suddivisione tra le più recenti ed autorevoli, quella degli Standards for Educational and Psychological Testing, elaborati congiuntamente da American Educational Research Association, American Psychological Association e National Council on Measurement in Education (da adesso Standards, AERA, APA, & NCME, 2014), ma che mantiene alcuni definizioni classiche, che secondo gli Standards non sono più utilizzate (es. la distinzione tra validità di costrutto e validità di criterio). Questa scelta riflette un allineamento rispetto alla terminologia che si potrebbe trovare in articoli o manuali di test neuropsicologici, in cui la tendenza è di usare termini più classici.
Dato il grande numero di classificazioni e di termini che saranno introdotti il rischio è quello di sentirsi un po’ smarriti. Il consiglio nell’affrontare di questo capitolo è quello di non perdere di vista il quadro generale, che è di fatto semplice: esistono diverse fonti di evidenza per validità e affidabilità che colgono le diverse sfaccettature di questi concetti. Le classificazioni sono semplicemente tentativi di raggrupparle per semplificarne la lettura.
2.3 Validità
2.3.1 Validità: introduzione
Nel contesto della Teoria Classica dei Test, la validità esprime quanto il punteggio vero \(T\) descrive correttamente ciò che si intende misurare1. Come per molti termini di questo libro, non esiste una definizione unanimamente accettata di validità. Di seguito ne è riportata una che ne cattura bene l’essenza principale.
Definizione
“La validità è il grado in cui un test misura effettivamente ciò che intende misurare.” (Slick, cap. 1 in Spreen & Strauss, 2006)
Un’altra definizione possibile, con una sfumatura leggermente diversa, la descrive come “la capacità di misurare quanto bene misura ciò che si propone di misurare, nel contesto in cui deve essere applicato” (Nunnally & Bernstein, 1994). In questo caso è messo in evidenza un aspetto importante, e cioè che la validità non è semplicemente una proprietà del test, ma può cambiare a seconda del contesto in cui è utilizzato.
È importante notare che ciò che si intende misurare non è necessariamente un costrutto (come la memoria o l’attenzione). Un test può infatti avere uno scopo diverso dalla misurazione di un concetto psicologico inosservabile: pensiamo, per esempio, a un test che deve prevedere le possibilità di reinserimento lavorativo dopo un trauma cranico, oppure a uno che deve distinguere pazienti con Mild Cognitive Impairment (MCI) da soggetti con invecchiamento fisiologico. In questi casi l’obiettivo è chiaro e misurabile, ma non è, in senso stretto, un «costrutto» (questo aspetto sarà ripreso nel par. sulla Validità di criterio). In accordo a visioni recenti la validità dovrebbe essere pensata come un concetto unitario (AERA, APA, & NCME, 2014), valutato attraverso diverse fonti di evidenza, che possono supportare una certa interpretazione dei risultati di un test.
A prescindere da come si definisca esattamente la validità, essa è quindi sempre associata alla presenza di evidenze scientifiche di diverso tipo, che forniscono una base per interpretare i punteggi. Un test con buona validità per la memoria, per esempio, dispone di evidenze scientifiche che ne confermano l’effettiva capacità di misurare la memoria; allo stesso modo, uno strumento in grado di distinguere pazienti con MCI da soggetti sani dispone di evidenze che ne dimostrano l’efficacia in questo compito.
Un aspetto che è fondamentale sottolinare sin da subito è che la validità non è una proprietà generale e assoluta di un test, ma è sempre riferita a un suo utilizzo specifico. Non ha pertanto senso dire semplicemente che “un test è valido”, mentre ha senso dire che un test ha evidenze di validità per un certo scopo, in una certa popolazione, in un certo contesto. Uno stesso test di memoria può avere buone evidenze di validità per identificare un decadimento cognitivo in soggetti anziani, e nessuna evidenza per, ad esempio, predire il rendimento scolastico in età evolutiva. Un altro modo per pensare a questo aspetto è che la validità non è una proprietà del test ma è una proprietà dell’interpretazione dei risultati del test per un certo scopo.
Non ha senso dire che un test “è valido”.
La validità non è una proprietà generale del test, ma è relativa ad una sua specifica interpretazione.
Un altro motivo per evitare affermazioni come “quel test è valido/non valido” è che la validità non è una proprietà tutto o nulla, ma una proprietà lungo un continuum2: un test accumula, nel tempo e attraverso diversi studi, un insieme di evidenze a favore (o contro) un determinato utilizzo, e la nostra fiducia nel test dovrebbe aggiornarsi di conseguenza.
Proprio per via della complessità spesso vengono riconosciuti diversi tipi di validità, ognuno in grado di cogliere aspetti diversi del test. Anche in questo caso non esiste una classificazione unanimamente riconosciuta. Questa complessità del concetto di validità e delle sue classificazioni è perfettamente testimoniata dai cambiamenti tra le due edizioni di “Essentials of Psychological Testing” di Susana Urbina (uno dei testi più diffusi sul testing psicologico) in cui la sezione sulla classificazione dei tipi di validità ha ricevuto una grande revisione (Urbina, 2004; Urbina, 2014).
Quella che troverete di seguito è una classificazione aggiornata, ispirata alle fonti di evidenza descritte dagli Standards (AERA, APA, & NCME, 2014), e adattata al contesto neuropsicologico, che identifica cinque aree3:
2.4 Possibili problemi della validità
Secondo la classificazione qui adottata è utile chiarire quali sono i principali problemi che un test potrebbe avere nella sua validità e cioè, la sottorapresentazione del costrutto o la varianza non legata al costrutto. Questi due difetti possono influenzare tutte e cinque le aree e dovrebbero sempre essere considerati per la valutazione della validità.
Con sottorappresentazione del costrutto si intende il problema che il test potrebbe avere quando non valuta in maniera completa il costrutto, potenzialmente inducendo ad interpretazioni sbagliate. Supponiamo per esempio di avere un test che si chiama TCL o “Test per la Comprensione del Linguaggio”, ma che ha item focalizzati solo su comprensione scritta e nessun item che indaga la comprensione orale. Un test del genere potrebbe indurre interpretazioni errate e generalizzate ad aree che il test di fatto non indaga. Il costrutto generico indicato nel nome del test, che si riferisce ad una generica “comprensione del linguaggio”, non è rappresentato adeguatamente. I dati che ci permettono di escludere questo tipo di problemi provengono soprattutto dalle Evidenze basate sul contenuto e dalle Evidenze basate sulla struttura interna.
Per varianza non legata al costrutto si intende il problema che può avere un test quando la variabilità dei suoi punteggi dipende sistematicamente da altri aspetti non legati al costrutto di interesse. Ad esempio un test di attenzione che è sistamaticamente legato ad alcuni aspetti di memoria a breve termine avrebbe problemi di questo tipo. Dati che ci permettono di valutare questi problemi vengono soprattutto dalle Evidenze basate sulle relazioni con altre variabili.
2.4.1 Una nota storica: la validità di facciata
Un termine che vale la pena di menzionare separatamente, e per motivi storici, è quello di validità di facciata. Questa è definita come il grado con cui un test appare misurare ciò che intende misurare, sulla base di un giudizio qualitativo e non di dati empirici.
Un test di memoria che chiede esplicitamente al paziente di “ricordare” una serie di elementi avrebbe un’alta validità di facciata per la memoria; un questionario sull’ansia i cui item chiedono “quanto ti senti nervoso/a” avrebbe un’alta validità di facciata per l’ansia. In entrambi i casi, chiunque guardi il test (paziente, clinico, valutatore esterno) ne intuirebbe lo scopo semplicemente osservandone il contenuto.
Il fatto che il termine validità di facciata (“face validity”) non compaia nemmeno una volta nelle oltre 230 pagine degli Standards (AERA, APA, & NCME, 2014), sembra proprio a sostegno del fatto che sia considerato un concetto superato e che anzi considerarla come un tipo di validità possa indurre ad errori. Per questo motivo è trattata qui come un concetto storico che vale la pena menzionare, ma non come un’evidenza di validità.
Essa è infatti spesso considerata come una proprietà importante semplicemente perché spesso è un requisito per la collaborazione del paziente e nella sua motivazione ad affrontare il test (Slick, cap. 1 in Spreen & Strauss, 2006). La chiarezza di un test rispetto ai suoi scopi non è però necessariamente una buona qualità di un test. In ambito forense, per esempio, i test progettati per rilevare la simulazione (malingering) o la propensione a mentire, devono essere appositamente disegnati in modo che non sia esplicito, per chi si sottopone al test, quale è il reale obiettivo.
Citare il concetto di validità di facciata come concetto oramai abbandonato è utile per sottolineare che un test potrebbe non essere un buono strumento di misurazione nonostante una buona apparenza. La ragione di questa potenziale discrepanza è legata molteplici ragioni: potrebbero esserci strategie alternative per affrontare il test che non si basano sulla funzione cognitiva attesa, le istruzioni potrebbero essere poco chiare, gli item del test potrebbero non comportarsi come dovrebbero per dei motivi che possono sfuggire ad una semplice analisi qualitativa. È per questo motivo che servono evidenze empiriche di validità, che sono trattate nei prossimi paragrafi.
2.4.2 Evidenze basate sul contenuto del test
La prima fonte di evidenza descritta dagli Standards riguarda il contenuto del test: in questo libro è chiamata, con l’etichetta classica, validità di contenuto.
2.4.2.0.1 Validità di contenuto
Definizione
La validità di contenuto è il grado in cui gli item di un test coprono in modo adeguato e rappresentativo tutti gli aspetti rilevanti di ciò che si intende misurare (spesso del costrutto di interesse).
Un test con buona validità di contenuto campiona in modo sistematico e completo l’intero dominio del costrutto. Ad esempio, un test per l’abilità di guida che simula molte condizioni di guida reali (traffico urbano, manovre, situazioni di emergenza) ha una validità di contenuto migliore di un test che valuta solo la conoscenza teorica del codice della strada. Al contrario, un test di lettura composto da sole parole isolate ha una validità di contenuto scarsa se lo scopo è valutare la comprensione di un testo, perché non considera aspetti rilevanti, come la capacità di leggere frasi o testi più lunghi e complessi.
Il modo più semplice di valutare la validità di contenuto è basarsi sul giudizio qualitativo di esperti, spesso gli autori del test stesso, che dovrebbero motivare le ragioni che hanno portato a disegnare un test e stabilire gli item, in una determinata maniera. Oltre a questo approccio, più qualitativo, esistono anche approcci quantitativi alla validità di contenuto. Il più famoso è sicuramente quello proposto da Lawshe (1975): un gruppo di giudici esperti valuta ogni singolo item, e le loro valutazioni vengono aggregate in un indice per item (Content Validity Ratio, CVR) e in un indice complessivo per il test (Content Validity Index, CVI)4. Più alto è il CVI maggiore è la validità di contenuto. Oltre al CVI esistono altri metodi, tra cui il più famoso è certamente il Delphi Consensus, un metodo tradizionalmente utilizzato per definire linee guida cliniche (de Vries et al., 2018). Questo è un metodo strutturato fatto da passi espliciti per raggiungere un accordo tra più esperti, che permette di identificare se gli item sono adeguati e anche se mancano item importanti all’interno del test. Una strategia alternativa per la valutazione della validità di contenuto è la presentazione di analisi quantitative, spesso solo descrittive, che si basano su domande e scale Likert create ad-hoc per raccogliere le opinioni degli esperti sull’appropriatezza del test e dei suoi item. Per un esempio di test neuropsicologici che riportano dati su validità di contenuto si possono consultare l’Assessment Battery for Communication, ABaCo (Sacco et al., 2008) e l’ Assessment of Pragmatic Abilities and Cognitive Substrates, APACS (Arcara & Bambini, 2016).
Soglia indicativa: la soglia minima suggerita per il CVI dipende dal numero dei giudici coinvolti (così come le tabelle con i valori soglia in funzione del numero di giudici coinvolti). Per il Delphi consensus non esiste una soglia specifica, ma essa deve essere esplicitata all’inizio (in genere può essere necessario l’accordo di almeno 80% degli esperti per mantenere un item all’interno del test). Per altri metodi costruiti ad hoc, non esistono soglie minime e gli autori dovrebbero fornire spiegazioni convincenti del perché la validità di contenuto è adeguata.
2.4.3 Evidenze basate sui processi di risposta
In accordo alla classificazione degli Standards, uno dei criteri di validità riguarda i processi di risposta, cioè quali processi portano a raggiungere il risultato. Quando si somministra un test, per esempio potrebbero essere usate delle strategie alternative, magari non previste, che però alterano la relazione tra costrutto di interesse e comportamento. Si pensi per esempio ad un test di memoria di parole in cui venga usata una mnemotecnica5 per ricordare le parole appena presentate. La performance potrebbe essere molto buona, ma non riflettere più il costrutto che si intende misurare quando si somministra quel test di memoria. Il tipo di processo coinvolto può essere investigato tramite tecniche come interviste, analisi dei tempi di risposta (se sono attesi diversi tempi di risposta a seconda del processo coinvolto), o altre tecniche, come l’analisi dei movimenti oculari.
Questo tipo di validità non è comunemente valutata nei test neuropsicologici e pertanto non ci si dovrebbe aspettare di trovare all’interno dei test sezioni specifiche su questo aspetto. Una probabile ragione è l’assunzione, implicita, che i test siano sufficientemente semplici da coinvolgere un insieme di processi simili tra i diversi partecipanti che effettuano il test. Questa è un’assunzione piuttosto forte, ma di fatto dominante, nella neuropsicologia clinica (si veda il Capitolo 11).
È interessante notare che nella storia della neuropsicologia clinica, lo studio dei processi di svolgimento dei compiti abbia avuto un ruolo importante. Il Boston Process Approach, termine coniato da Edith Kaplan (Kaplan, 1988), è stato un approccio alla neuropsicologia clinica focalizzato appunto sull’analisi del modo in cui i pazienti svolgevano i compiti, piuttosto che dei risultati ottenuti ai test (White & Rose, cap. 6 in Goldstein & Incagnoli, 1997). Storicamente però questa attenzione è scemata e la maggior parte dei test neuropsicologici adesso non indaga più i processi di svolgimento del compito, a favore di una maggior attenzione sul risultato.
2.4.4 Evidenze basate sulla struttura interna
La terza fonte di evidenza riguarda la struttura interna del test: nella classificazione classica corrisponde a quella che viene chiamata struttura fattoriale.
2.4.4.1 Struttura fattoriale
Con questo tipo di validità si indica la qualità degli item del test di raggrupparsi in modo coerente con il modello teorico del costrutto, tipicamente verificata con l’analisi fattoriale esplorativa (Exploratory Factor Analysis, EFA) o confermativa (Confirmatory Factor Analysis, CFA). Talvolta viene impiegata a questo scopo anche l’analisi delle componenti principali (Principal Component Analysis, PCA)6. Tutti gli aspetti legati all’utilizzo di formule e metodi statistici di queste analisi sono trattate nella Parte II – Approfondimenti tecnici.
In breve, l’analisi fattoriale ha come scopo quello di capire se le relazioni di variabili osservate possono essere spiegate, almeno in parte, da un numero più ristretto di variabili latenti, chiamate fattori. Nel contesto del testing psicologico e neuropsicologico, il più delle volte le variabili osservate, o indicatori, sono i punteggi a ciascun item dei test (es. i punteggi agli item di un test), mentre i fattori sono in genere costrutti (ad es., la memoria a breve termine) o combinazioni di costrutti. Nell’analisi fattoriale esplorativa lo scopo è indagare quale è il numero plausibile di fattori che possono spiegare in maniera adeguata la relazione tra gli item e altri aspetti (ad esempio la relazione tra i fattori). Nell’analisi fattoriale confermativa lo scopo è quanto la struttura fattoriale osservata sia compatibile ad una ipotizzata a priori, ad esempio che un solo fattore sia sufficiente a spiegare i pattern di relazione tra gli item.
Affinché i risultati di un’analisi fattoriale siano a supporto della validità di costrutto dovrebbe mostrare che gli item del test si comportano in modo coerente con ciò che ci si attende rispetto al costrutto o ai costrutti misurati. L’analisi fattoriale è infatti spesso utilizzata in fase di sviluppo dei test, come strumento statistico per selezionare quali item tenere e quali invece escludere dalla versione finale. Quando si parla di sviluppo di un test, in genere ci si attende uno di questi due scenari: nel caso ci siano forti ipotesi su una possibile struttura, che sia presentata una CFA. Nel caso invece in cui non sia chiara la struttura del test, può essere presente una prima EFA, seguita poi da una CFA7.
Supponiamo di avere un questionario (l’analisi fattoriale è usata più comunemente nei questionari), che valuta qualità di vita legata ai disturbi cognitivi percepiti. Il questionario potrebbe comporsi di due sezioni. I primi dieci item che indagano i disturbi cognitivi percepiti e altri dieci item che indagano i disturbi psicologici percepiti. La struttura interna del questionario avrebbe supporto da un’analisi fattoriale se, conducendo un’analisi di questo tipo su dati raccolti su numerosi partecipanti si trovasse che effettivamente i primi dieci item saturano8 principalmente su un fattore, mentre i rimanenti item saturano principalmente su un altro fattore. L’analisi fattoriale è usata anche per capire se alcuni item sono da rimuovere. Ad esempio un item, nonostante di facciata appaia perfetto, potrebbe empiricamente comportarsi in maniera scollegata dagli altri (ad esempio avendo valori di saturazioni molto bassi su un fattore), suggerendo che non è legato allo stesso costrutto.
Passiamo adesso ad un ipotetico test di prestazione massima e, in particolare, ad un test che misuri la memoria di lavoro. Assumendo che questo test misuri principalmente una sola funzione cognitiva, è verosimile attendersi dall’analisi fattoriale che gli item saturino principalmente su un singolo fattore.
È da notare, che da sola l’analisi fattoriale non ci permette mai di sapere da sola quale è il costrutto (o i costrutti) che si sta misurando, ma solo che gli item si stanno comportando in maniera coerente. L’interpretazione, e quindi l’etichetta che diamo ai fattori, dipende anche dal contenuto degli item, dal modello teorico e da ulteriori evidenze, come le relazioni dei punteggi con altre variabili. Tornando all’esempio del questionario, se la sottoscala ottenuta sommando i primi dieci item correlasse effettivamente con un altro test che indaga i disturbi cognitivi percepiti, avremmo ragione di interpretare in questo senso il punteggio alla sottoscala, alla luce della natura degli item. L’analisi fattoriale ci dice se si comportano in maniera coerente, ma per poterli interpretare come indice su disturbi psicologici percepiti, sarebbe ideale avere anche altre evidenze, ad esempio correlando la sottoscala con un altro test aspetti legati ai disturbi psicologici.
Passando al secondo esempio del test di memoria in cui gli item saturano tutti su uno stesso fattore, questo ci dice che gli item sono presumibilmente legati allo stesso costrutto. Se poi il punteggio totale del test correlasse in maniera soddisfacente con un altro test di memoria di lavoro, questo sarebbe evidenza che un’etichetta ragionevole per il costrutto misurato è proprio “memoria di lavoro”.
Non bisogna però pensare che questionari o test di prestazione massima debbano avere risultati coerenti con una soluzione fattoriale, dal momento che questo dipende da come è definito il costrutto. L’analisi fattoriale è particolarmente appropriata quando gli item sono concepiti come manifestazioni di un singolo costrutto e ci si attende quindi che siano correlati, ad esempio, item che testano la memoria in un test di memoria. Questi sono detti costrutti riflessivi. Non è invece necessario che un’analisi fattoriale trovi uno o più fattori quando gli item descrivono componenti diverse che, nel loro insieme, definiscono un indice su base teorica, cioè è la combinazione di questi indici che forma un nuovo costrutto. Questi sono detti costrutti formativi. Ne è un’esempio la Riserva Cognitiva (Nucci, Mapelli, & Mondini, 2012; Stern, 2009), composta teoricamente da più aspetti che non sono necessariamente collegati e anzi, anche a livello teorico potrebbero comportarsi in maniera separata.
Soglie indicative: Non esistono soglie generali per l’analisi fattoriale visto che i risultati attesi dipendono dalla teoria. Esistono diverse metriche per valutare l’adeguatezza delle soluzioni di un’analisi fattoriale e diversi valori soglia proposti in letteratura. Si rimanda al paragrafo su analisi fattoriale nella Parte II – Approfondimenti tecnici per i dettagli.
2.4.5 Evidenze basate sulle relazioni con altre variabili
La quarta fonte di evidenza descritta dagli Standards riguarda la relazione tra il punteggio del test e altre variabili esterne. È la più ampia delle cinque fonti, e se si fa riferimento ad una terminologia più classica comprende diverse etichette che sono spesso trattate separatamente: la validità di costrutto (per gli aspetti non già coperti dalla struttura interna), la validità di criterio e la validità ecologica.
2.4.5.1 Validità di costrutto
La validità di costrutto è storicamente considerata la più importante tra le validità, ed è spesso presentata come quella verso cui tutte le altre convergono: alcune classificazioni di fatto considerano tutte le validità come nient’altro che diverse sfaccettature della validità di costrutto. Questo però dipende da ciò che noi decidiamo di definire “costrutto”. In accordo agli Standards, il concetto di costrutto è ben più ampio di quello riportato in questo libro e include anche quello di criterio. La loro definizione di costrutto è “il concetto o caratteristica che il test dovrebbe misurare” (AERA, APA, & NCME, 2014, p. 11). Per rimanere più aderente ai termini utilizzati spessi in neuropsicologia e per maggiore chiarezza, ho preferito mantenere la distinzione tra costrutto (concetto psicologico inosservabile) e criterio, come caratteristica osservabile (Cronbach & Meehl, 1955).
Non stupisce quindi che, nella cornice adottata in questo capitolo, ciò che tradizionalmente chiamiamo “validità di costrutto” non sia una fonte a sé, ma si distribuisca su due delle cinque fonti di evidenza: la struttura interna, vista in precedenza, e le relazioni con altre variabili, trattata in questo paragrafo.
Definizione
La validità di costrutto è il grado in cui i punteggi di un test si comportano in accordo con la teoria del costrutto che il test intende misurare.
Tradizionalmente la validità di costrutto viene scomposta in tre aspetti: la struttura fattoriale, considerata come evidenza basata sulla struttura interna, la validità convergente/divergente e la coerenza dei risultati con la teoria del costrutto, trattate di seguito come evidenze basate sulle relazioni con altre variabili.
La validità di costrutto, e in particolare la struttura fattoriale, sono spesso associate al concetto di invarianza di misura, la proprietà di un test di misurare la stessa cosa anche in diverse condizioni (ad esempio in diverse popolazioni di pazienti). Questo aspetto è leggermente approfondito nel paragrafo Focus: Invarianza di misura nei test neuropsicologici e più in dettaglio nel capitolo dedicato della Parte II – Approfondimenti tecnici.
2.4.5.2 Validità convergente/divergente
Con questo nome si intende la capacità del punteggio del test di convergere o divergere in maniera coerente con altre misure.
Validità convergente: è la qualità del punteggio al test di correlare con altre misure dello stesso costrutto, o di costrutti teoricamente vicini. Ad esempio, un test di memoria è atteso che correli con altri test di memoria. Un test di abilità di comprensione del linguaggio, avrebbe evidenza di validità di costrutto se il punteggio correlasse con un altro test che misura abilità di comprensione del testo scritto (che è una parte della comprensione del linguaggio).
Validità divergente (o discriminante): è la qualità del punteggio al test di avere correlazioni basse con misure di costrutti teoricamente distinti. Per esempio, un test che misuri un test di comprensione del linguaggio, dovrebbe correlare poco con test di memoria differita, se si assume che i due strumenti misurano davvero costrutti diversi. Questo tipo di validità è molto importante per valutare la selettività con cui un test misura un costrutto, piuttosto che effetti aspecifici e generali. Si noti infatti che generalmente i test neuropsicologici tendono ad essere molto correlati fra loro (es. Treviño et al., 2021; Mondini et al., 2022).
Soglie indicative: Per la validità di costrutto non esiste un valore soglia universale (una correlazione convergente “abbastanza alta” o divergente “abbastanza bassa”), il che la rende tra le più difficili da interpretare. È quindi compito della/del neuropsicologa/o leggere con giudizio e valutare se sono sufficienti le eventuali motivazioni a sostegno delle interpretazione sulla validità di costrutto. Come prima indicazione, le correlazioni con test che misurano lo stesso costrutto dovrebbero quantomeno essere più alte delle correlazioni con test che misurano costrutti diversi. Dovrebbero inoltre essere riportare delle motivazioni convincenti del perché le correlazioni supportano la validità di costrutto. Un approfondimento di altri modi per valutare la validità di costrutto può essere trovata nel paragrafo Focus: valutare la validità di costrutto
2.4.5.3 Relazioni con altre variabili coerenti con il costrutto
In questo terzo gruppo rientrano le evidenze non comprese nei due precedenti, ma comunque capaci di sostenere la validità dell’interpretazione dei punteggi.
In linea generale, ogni risultato che mostri come i punteggi del test si comportino secondo previsioni derivate dalla teoria del costrutto può fornire evidenze a favore della loro validità. La forza di tali evidenze dipende, tuttavia, dalla precisione delle previsioni formulate: non è sufficiente osservare una relazione qualsiasi, ma occorre che la sua direzione e, possibilmente, la sua intensità siano coerenti con quanto previsto.
Queste evidenze possono riguardare anche le relazioni con costrutti diversi da quello principalmente misurato dal test. Per esempio, se si assume che l’esecuzione di un test di memoria richieda anche un modesto coinvolgimento dell’attenzione, una correlazione debole o moderata con i punteggi ottenuti in test attentivi potrebbe risultare coerente con la teoria. Una correlazione troppo elevata, al contrario, potrebbe sollevare il dubbio che il test misuri l’attenzione in misura maggiore di quanto desiderato.
Queste previsioni possono riguardare variabili demografiche o cliniche. Se la teoria prevede che la prestazione vari con l’età, una relazione nella direzione attesa può fornire evidenze di validità. Analogamente, punteggi mediamente più bassi in una popolazione clinica nella quale si prevede una compromissione del costrutto misurato possono sostenere l’interpretazione proposta. Questi ultimi risultati devono comunque essere valutati con cautela, perché le differenze osservate potrebbero dipendere anche da altre caratteristiche dei gruppi considerati (si veda il paragrafo su Invarianza di Misura).
Soglie indicative: Anche per questo tipo di validità non esistono soglie minime, anche perché non esiste un’analisi specifica per valutarla (qualsiasi analisi che mostri la coerenza dei punteggi con la teoria legata al costrutto sarebbe adeguata). I valori che sono ritenuti a supporto della validità dovrebbero però essere motivati e giustificati.
2.4.5.3.1 Validità di criterio
In alcuni casi, la validità di un test viene valutata esaminando la relazione tra i suoi punteggi e una variabile esterna direttamente osservabile, denominata criterio. Si parla allora di validità di criterio.
Definizione
La validità di criterio indica il grado in cui i punteggi di un test risultano associati a un criterio esterno rilevante, misurabile e stabilito indipendentemente dal test stesso.
Nella cornice adottata in questo capitolo, la validità di criterio è presentata come una sotto-voce delle evidenze basate sulle relazioni con altre variabili, per uniformarsi all’impostazione unitaria degli Standards (AERA, APA, & NCME, 2014). È utile però tenere presente che si tratta di un tipo di evidenza concettualmente diverso da quello discusso a proposito del costrutto: mentre un costrutto è per definizione non direttamente osservabile, un criterio è (almeno in linea di principio) una variabile osservabile e stabilita indipendentemente dal test. Non è un caso che il termine “validità di costrutto” sia stato introdotto proprio in contrapposizione a questa situazione (Cronbach & Meehl, 1955).
Questa distinzione, per quanto sfumata nella cornice più recente degli Standards, resta utile nella pratica neuropsicologica: per un costrutto inosservabile servono evidenze convergenti e coerenza teorica, mentre per un criterio osservabile ha senso un confronto più diretto, come quelli discussi nel resto di questo paragrafo. Questo approccio è pienamente catturato da alcune posizioni che sottolineano l’importanza di focalizzarsi su validità di criterio quando lo scopo clinico è identificare specifiche patologie (Ilardi, 2026).
Nel contesto della neuropsicologia clinica, il criterio può essere rappresentato da una variabile continua oppure categoriale9.
Nel primo caso, il criterio può essere, per esempio, il punteggio ottenuto mediante una procedura di valutazione lunga e approfondita. Talvolta questa procedura viene considerata un gold standard, ossia il migliore metodo disponibile per valutare una determinata condizione o raggiungere una specifica conclusione clinica. Si noti che un altro test non costituisce automaticamente un gold standard: in genere, affinché sia considerata criterio, dovrebbe avere qualità tali da poter essere considerato la migliore alternativa possibile.
La validità di criterio viene frequentemente studiata nei test detti di screening, brevi test, e spesso utilizzati nelle valutazioni di primo livello per avere informazioni rapide e generiche sul funzionamento cognitivo (si veda il paragrafo Oggetti di interesse dei test neuropsicologici). Lo scopo di questi strumenti può essere, per esempio, prevedere l’esito di una valutazione neuropsicologica più estesa, come il punteggio globale ad una batteria, oppure discriminare tra persone appartenenti a differenti categorie diagnostiche, come persone con Mild Cognitive Impairment e persone senza disturbi cognitivi.
Quando il criterio è categoriale, questo tipo di validità è anche noto come validità per gruppi noti (known-groups validity). I gruppi noti sono in generale categorie diagnostiche, ma potrebbe essere altre categorie rilevanti a fini clinici (es. un test di abilità finanziarie il FCAI, ha presentato come prova di validità la capacità di discriminare tra chi aveva, o meno l’amministratore di sostegno (Kershaw & Webber, 2008)).
In base alla relazione temporale tra la somministrazione del test e la rilevazione del criterio, si distinguono tradizionalmente la validità concorrente e la validità predittiva.
Validità concorrente. Si parla di validità concorrente quando il test e il criterio vengono misurati nello stesso momento, o comunque a una distanza temporale sufficientemente breve da rendere improbabile un cambiamento rilevante nella condizione esaminata.
Un esempio è rappresentato dalla relazione tra il punteggio ottenuto a un breve test di screening e l’esito di una batteria neuropsicologica più approfondita somministrata nella stessa sessione.
Quando il criterio è categoriale, la validità concorrente può essere indagata verificando se i punteggi del test discriminano condizioni diagnostiche stabilite approssimativamente al momento della valutazione. Il MoCA (Nasreddine et al., 2005) e il MMSE (Folstein et al., 1975), i due test più diffusi e famosi per lo screening di MCI e delle demenze, rispettivamente, sono stati originariamente sviluppati valutando la capacità dei loro punteggi di distinguere gruppi con differenti condizioni di funzionamento cognitivo.
In ambito forense, la validità di criterio concorrente viene utilizzata anche nello sviluppo di strumenti finalizzati a discriminare prestazioni di potenziali simulatori da quelli di non simulatori, definiti a priori in ambito sperimentale. L’argomento sarà approfondito nel Capitolo 7.
Validità predittiva. Si parla invece di validità predittiva quando il criterio esterno viene rilevato in un momento successivo rispetto alla somministrazione del test.
Un esempio è rappresentato da un punteggio neuropsicologico rilevato ad una prima valutazione e utilizzato per predire la diagnosi di demenza a due anni di distanza. Analogamente, un test di previsione della prestazione scolastica può essere valutato in base alla sua capacità di predire gli esiti scolastici alla fine dell’anno.
Il criterio futuro può essere anche categoriale. Per esempio, il ritorno al lavoro dopo uno stroke può essere codificato come esito dicotomico (sì/no). Valutare se il punteggio ottenuto a un test somministrato nella fase iniziale sia in grado di predire la probabilità di un successivo reinserimento lavorativo costituisce un’indagine della validità predittiva del test.
Soglie indicative: Non esiste una soglia universale oltre la quale la validità di criterio possa essere considerata automaticamente adeguata. L’interpretazione dipende dalla natura del criterio, dalla finalità del test, dalla qualità della misura di riferimento e dalle conseguenze delle decisioni che verranno prese sulla base del punteggio.
Quando il criterio è continuo, la relazione viene spesso espressa mediante un coefficiente di correlazione. Valori pari o superiori a 0.70–0.80 possono essere considerati elevati in molti contesti applicativi, ma appunto non rappresentano requisiti universalmente validi.
Quando il criterio è categoriale, possono essere utilizzati indici quali sensibilità, specificità e area sotto la curva ROC. Anche in questo caso, valori pari o superiori a 0.80 sono talvolta proposti come indicativamente adeguati, ma la loro interpretazione deve tenere conto dello scopo del test, della prevalenza della condizione e dei costi associati ai falsi positivi e ai falsi negativi. Questi indici e la scelta dei punteggi di soglia sono approfonditi nei capitoli dedicati della Parte II – Approfondimenti tecnici.
2.4.5.3.2 Validità ecologica
Per la sua centralità in ambito clinico e forense, la validità ecologica merita qui una trattazione a sé, pur rientrando concettualmente tra le evidenze basate sulle relazioni con altre variabili.
Definizione
La validità ecologica è il grado in cui il punteggio di un test predice il comportamento della persona nella vita quotidiana reale, al di fuori del contesto di somministrazione.
Si valuta tipicamente calcolando la correlazione tra il punteggio del test e misure del funzionamento quotidiano, per esempio scale di attività della vita quotidiana (ADL/IADL), questionari compilati dal paziente o da un caregiver o altri indici che sono relativi alla vita quotidiana (es. numero di comportamenti inappropriati).
La validità ecologica è raramente disponibile, in parte perché raccogliere dati sul funzionamento quotidiano reale è più difficile e costoso che raccogliere altri tipi di evidenza (come la relazione con altri test). È però una dimensione particolarmente rilevante in neuropsicologia clinica e forense, dove l’obiettivo ultimo della valutazione è spesso proprio stabilire l’impatto di un deficit cognitivo sul funzionamento della persona nella vita reale, al di fuori dell’ambulatorio e del setting di valutazione. Per considerazioni legate si veda il Capitolo 10 su interpretazione ai test.
La validità ecologica non va confusa con l’ecologicità di un test, un termine collegato, ma non un sinonimo. Con ecologicità di un test indichiamo quanto il test presenta delle situazioni che sono analoghe o ricalcano quelle della vita quotidiana. Ad esempio, un test che ha l’obiettivo di valutare le abilità di guida e che utilizzi un simulatore con un volante, un cambio e dei pedali, è certamente dotato di grande ecologicità. Questa però è solo presumibilmente, e non necessariamente, un indice di validità ecologica, cioè capacità di predire come ci si comporterà nella vita quotidiana e quindi in condizioni di guida reale, che andrebbe dimostrata empiricamente.
Soglia indicativa: non esiste un valore soglia condiviso in letteratura per giudicare la validità ecologica come sufficiente, anche perché non esiste un’analisi standard. Spesso sono riportate correlazioni o analisi di regressione (es. Higginson, Arnett, & Voss, 2000).
2.4.6 Evidenze basate sulle conseguenze dei test
Uno degli aspetti importanti che, secondo gli Standards, dovrebbe essere valutato e approfondito è la presenza di eventuali conseguenze, soprattutto non intenzionali, derivanti dall’uso del test. In particolare, occorre verificare se tali conseguenze dipendano da limiti nella validità delle interpretazioni dei punteggi per l’uso previsto (si veda il par. Possibili problemi della validità).
Ad esempio, un test neuropsicologico utilizzato in età evolutiva potrebbe classificare sistematicamente in modo diverso persone appartenenti a gruppi con differente stato socioeconomico, penalizzandone alcune nell’accesso ai servizi di supporto. Questa potrebbe rappresentare una conseguenza non intenzionale di grande rilevanza sociale ed etica.
Un altro esempio potrebbe riguardare l’accesso a trial farmacologici vincolato ai punteggi ottenuti a un determinato test. Se le interpretazioni dei punteggi per questo uso presentassero problemi di validità, il test potrebbe penalizzare sistematicamente alcuni gruppi di persone e impedire loro di accedere al trial.
Non bisogna però ritenere che una conseguenza negativa dell’uso di un test per un gruppo di persone costituisca necessariamente, di per sé, un indice di scarsa validità. Si può parlare di un problema di validità quando la conseguenza è riconducibile a un limite nell’interpretazione dei punteggi, per esempio, all’influenza sui risultati al test di caratteristiche estranee al costrutto o a problemi di contenuto, che non riflette differenze effettive nel costrutto di interesse. Anche quando non segnala un problema di validità, una conseguenza negativa può comunque rimanere rilevante sul piano sociale, etico o delle decisioni sull’uso del test, ma questo è un aspetto distinguibile.
Questo aspetto della validità non è associata ad un nome specifico e non è classicamente valutata, ma è un aspetto certamente importante che dovrebbe essere valutato sia da chi sviluppa il test, sia da chi lo utilizza (si veda il Capitolo 8 Scegliere i test Neuropsicologici)
2.5 Validità: riassunto
Abbiamo esaminato diversi tipi di Validità, secondo la classificazione proposta, che parte dai principi degli Standards , che riassumono in cinque macrocategorie, ma mantenendo la nomenclatura classica (es. validità di costrutto, di contenuto, etc.). In questa maniera una classificazione aggiornata e rigorosa può essere vista in parallelo a quei termini che è più probabile trovare in articoli o manuali di test neuropsicologici. La tabella di seguito riassume i tipi di validità (secondo le diversi classificazioni) e anche i principi base per valutarli.
Tabella riassuntiva Validità:
| Fonte di evidenza (Standards 2014) | Etichetta classica | Come si valuta | Soglia indicativa |
|---|---|---|---|
| Contenuto | Validità di contenuto | Giudizio di esperti; CVI/CVR (Lawshe, 1975) | Dipende dal numero di giudici |
| Struttura interna | Struttura fattoriale | Analisi fattoriale (EFA/CFA) | Dipende dal modello teorico |
| Relazioni con altre variabili | Convergente | Correlazione con test dello stesso costrutto | Nessun valore universale |
| Relazioni con altre variabili | Divergente | Correlazione (bassa attesa) con costrutto diverso | Nessun valore universale |
| Relazioni con altre variabili | Coerenza con la teoria del costrutto | Qualsiasi analisi coerente con previsioni teoriche | Nessuna (motivazione qualitativa) |
| Relazioni con altre variabili | Concorrente | Correlazione con criterio esterno simultaneo | ≥ 0.70-0.80 |
| Relazioni con altre variabili | Predittiva / gruppi noti | Correlazione, oppure sensibilità/specificità | ≥ 0.80 per sensibilità/specificità |
| Relazioni con altre variabili | Ecologica | Correlazione con scale di vita quotidiana | Nessuna soglia condivisa |
| Processi di risposta | Nessuna corrispondenza con etichette classiche | Interviste, tempi di risposta,(raramente documentata nei test neuropsicologici) | Nessuna soglia indicativa |
| Conseguenze del testing | Nessuna corrispondenza con etichette classiche | Analisi delle conseguenze, intenzionali e non, dell’uso del test (raramente documentata nei test neuropsicologici) | Nessuna soglia indicativa |
2.6 Affidabilità
2.6.1 Affidabilità: introduzione
Definizione
L’affidabilità è la qualità di un test di fornire punteggi consistenti in diverse misurazioni; può essere intesa come la precisione di un test.
Tornando all’equazione cardine della CTT (\(X = T + E\)), l’affidabilità esprime quanto la componente d’errore \(E\) sia piccola rispetto al punteggio osservato \(X\): un test molto affidabile è un test in cui, in diverse misurazioni, \(E\) resta sistematicamente piccolo, e i punteggi osservati approssimano con maggiore precisione il punteggio vero \(T\).
Gli Standards for Educational and Psychological Testing (AERA, APA, & NCME, 2014) usano il termine ombrello “affidabilità/precisione” (reliability/precision) proprio per sottolineare che l’affidabilità non è un’unica proprietà, ma un insieme di stime di precisione, ciascuna specifica alla fonte di errore che si intende quantificare i cui termini specifici possono dipendere dal modello di misurazione di riferimento: modelli come la Teoria della Generalizzabilità (Generalizability Theory) e l’Item Response Theory usano infatti terminologie e concetti diversi10. La terminologia classica usata in questo libro (consistenza interna, test–retest, forme parallele) si riferisce alla CTT che, come già detto, è il modello dominante utilizzato per lo sviluppo di test neuropsicologici.
Come per l’affidabilità è importante considerare che questa proprietà è sempre da considerare come valutata all’interno di un certo specifico contesto. Non ha pertanto senso pensare alla affidabilità come una proprietà generica e immutabile di un test, ma come qualcosa che è stata testata in specifiche situazioni (es. con campioni da specifiche popolazioni, con specifiche fasce di età, etc.), e che non potrebbe generalizzare a contesti non direttamente testati.
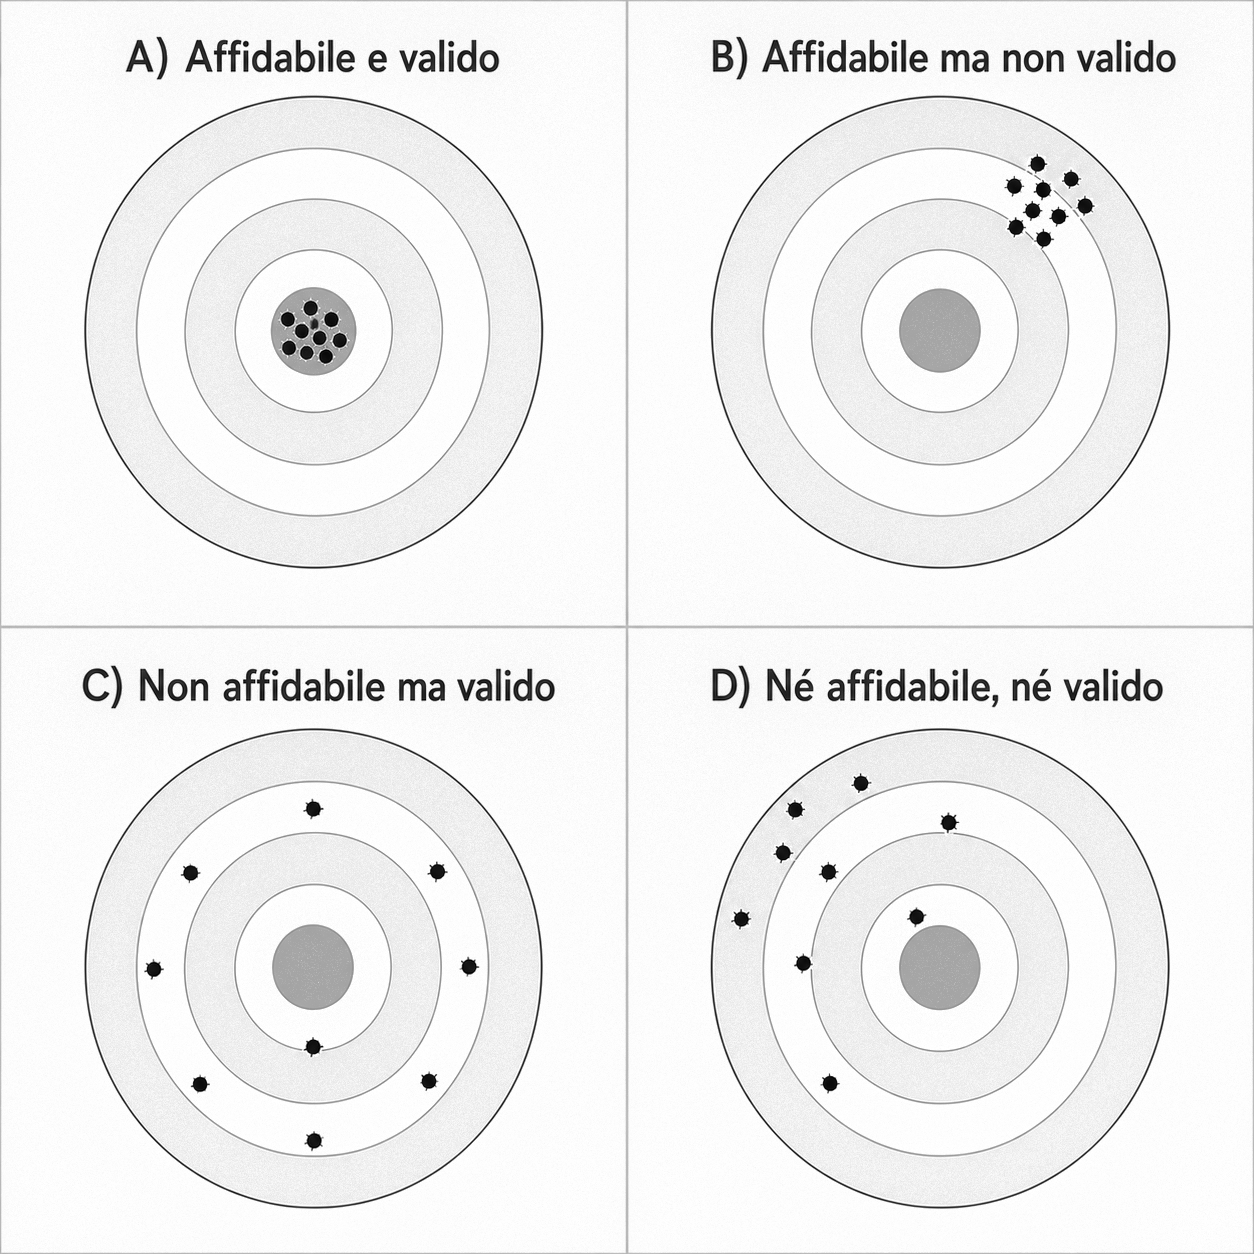
Affidabilità e validità sono concetti distinti ma collegati, in un modo spesso riportato con l’analogia tra accuratezza (per la validità) e precisione (per l’affidabilità): un test può essere affidabile senza essere valido, cioè misurare qualcosa con grande precisione, ma non il costrutto che ci interessa. Il contrario non è invece possibile: un test valido deve necessariamente essere anche affidabile, perché non è possibile misurare bene un costrutto con uno strumento impreciso. L’affidabilità è quindi una condizione necessaria, ma non sufficiente, per la validità.
Come abbiamo già visto per la validità una domanda comune è: l’affidabilità del mio test è sufficiente alta? Questa è una domanda delicata in cui la risposta dipenda anche dal tipo di utilizzo che si intende fare con il test. Di seguito è riportata una classificazione generale della grandezza dei coefficienti di affidabilità, che vale come riferimento orientativo per tutti i tipi di affidabilità trattati di seguito (Slick, cap. 1 in Spreen & Strauss, 2006):
| Grandezza del coefficiente | Interpretazione |
|---|---|
| ≥ 0.90 | Molto alta |
| 0.80-0.89 | Alta |
| 0.70-0.79 | Adeguata |
| 0.60-0.69 | Marginale |
| < 0.60 | Bassa |
Anche in questo caso le soglie sono da considerare come indicative: per le decisioni cliniche, Sattler (2001) (citato in Slick, cap. 1 in Spreen & Strauss, 2006) propone soglie più stringenti: per i test usati nella valutazione del singolo individuo si raccomanda un’affidabilità pari o superiore a 0.80; per i test usati per decisioni particolarmente importanti (per esempio la stima del QI o una diagnosi), 0.90 è considerato il minimo assoluto, e 0.95 il valore ottimale.
È da notare che anche in questo aspetto la letteratura non è unanime, e non è raro che test pubblicati e ampiamente utilizzati circolino con valori di affidabilità ben al di sotto di quelli raccomandati. Per tale ragione, per quanto riguarda i valori di affidabilità, suggerisco un approccio comparativo: meglio scegliere i test con affidabilità più alta (e con più evidenze di affidabilità), interpretando con cautela quando l’affidabilità è al di sotto di valori raccomandati (si veda anche il paragrafo Nella pratica clinica: Come usare affidabilità e validità per scegliere i test).
2.6.1.1 Affidabilità split-half
Definizione
L’affidabilità split-half indica la consistenza di un test quando si confrontano il punteggio totale ottenuto da metà degli item con il punteggio totale ottenuto con la rimanente metà degli item.
L’affidabilità split-half stima l’affidabilità di un test dividendolo in due metà (tipicamente gli item pari da un lato e gli item dispari dall’altro) e calcolando la correlazione tra i punteggi ottenuti sulle due metà. Il vantaggio principale è la semplicità nell’ottenerla, visto che si può facilmente calcolare dopo una sola somministrazione del test. Il limite principale è che il risultato dipende, almeno in parte, da come viene effettuata la divisione in due metà, che resta in una certa misura arbitraria.
Poiché ciascuna metà è più corta dell’intero test, e un test più corto tende ad essere meno affidabile di uno più lungo, il coefficiente di correlazione tra le due metà sottostima l’affidabilità del test completo. Per correggere questa sottostima si applica tipicamente la correzione di Spearman-Brown11. Data la sua limitazione spesso all’affidabilità split-half è preferita la sua estensione, la consistenza interna trattata nel prossimo paragrafo.
Soglie indicative: per essere considerata sufficiente la correlazione split-half dovrebbe essere pari o superiore a 0.70-0.80 (Slick, cap. 1 in Spreen & Strauss, 2006).
2.6.1.2 Consistenza interna
Definizione
La consistenza interna misura quanto gli item di un test siano tra loro coerenti, cioè quanto misurino, almeno in parte, la stessa cosa.
La consistenza interna rappresenta tuttora uno dei principali approcci alla stima dell’affidabilità nell’ambito della Teoria Classica dei Test. Per la sua definizione la consistenza interna è un concetto a cavallo tra affidabilità e validità ed è legata alla struttura fattoriale del test in quanto stima quanto gli item siano legati tra loro e, presumibilmente, misurino un’unico costrutto. L’indice più diffuso per calcolare la consistenza interna è l’alfa di Cronbach (\(\alpha\)), che varia da 0 a 1 e può essere pensato, in modo intuitivo, come la media di tutte le possibili affidabilità split-half calcolabili su quel test (vedi paragrafo precedente). Un’alternativa più recente, e in generale considerata più robusta, all’alpha di Cronbach è l’omega di McDonald (\(\omega\))12. Da notare che per i test di velocità (in cui il punteggio dipende dal numero di item completati entro un tempo limite, più che dalla loro correttezza) la consistenza interna, sia calcolata come alpha sia come split-half, non è una misura di affidabilità appropriata (Slick, cap. 1, in Spreen & Strauss, 2006).
Soglie indicative: come riportato in Slick, 2006 (cap. 1, in Spreen & Strauss, 2006): valori inferiori a 0.70 sono considerati inaccettabili, tra 0.70 e 0.79 discreti, tra 0.80 e 0.89 buoni, e pari o superiori a 0.90 eccellenti. Nei test neuropsicologici la consistenza interna tende però ad essere più bassa della media, spesso intorno a 0.60.
2.6.1.3 Affidabilità test–retest
Definizione
L’affidabilità test–retest è una misura della consistenza dei punteggi ottenuti quando lo stesso test viene somministrato alle stessa persone in due momenti diversi, assumendo che nell’intervallo tra le somministrazioni non si siano verificati cambiamenti reali nel costrutto misurato e che le condizioni di valutazione siano comparabili.
L’affidabilità test–retest è uno dei principali aspetti di affidabilità di un test e in numerosi casi è proprio considerato il più importante (Slick, cap. 1 in Spreen & Strauss, 2006). Questo tipo di affidabilità ha però una serie di caratteristiche e sfumature che è importante approfondire per una corretta interpretazione. Innanzitutto l’affidabilità test–retest, del resto come altre proprietà, non è una proprietà univoca e immutabile del test, ma dipendente dal contesto in cui è valutata: la sua stima dipende dalla popolazione considerata, dalle condizioni di somministrazione e, soprattutto, dall’intervallo tra test e retest. Due aspetti meritano particolare attenzione:
Dipendenza dall’intervallo: uno stesso punteggio non possiede un unico valore di affidabilità test–retest. In genere, il coefficiente tende a essere più elevato quando l’intervallo è breve, mentre intervalli più lunghi aumentano la possibilità che si verifichino cambiamenti reali nella caratteristica misurata o che variabili contestuali influenzino la prestazione.
Effetto pratica: in diversi test cognitivi (specie i test di prestazione massima) la seconda somministrazione può beneficiare dell’esperienza acquisita durante la prima. Un miglioramento sistematico può non essere rilevato da alcuni indici comunemente utilizzati per quantificare l’affidabilità test–retest, come il coefficiente di correlazione o una ICC basata sulla consistenza e non su accordo (Slick, cap. 1 in Spreen & Strauss, 2006).
In ambito clinico, l’affidabilità test–retest è particolarmente rilevante quando si assume che il punteggio rappresenti una caratteristica relativamente stabile oppure quando si vogliono confrontare valutazioni effettuate in momenti diversi. Tuttavia, il solo coefficiente di affidabilità non permette di stabilire se la variazione osservata nel singolo individuo sia sufficientemente ampia da superare l’errore di misurazione. A questo scopo sono necessarie procedure specifiche, eventualmente corretti per l’effetto pratica (si veda il capitolo indagare cambiamenti nel tempo).
Rilevanza per una singola misurazione
Contrariamente a quanto si potrebbe pensare, l’affidabilità test–retest non è importante soltanto quando si vogliono confrontare misurazioni effettuate in tempi diversi: se il punteggio è interpretato come misura di una caratteristica relativamente stabile, la singola somministrazione può essere concepita come una delle molte possibili somministrazioni del test. Nella Teoria Classica dei Test, il punteggio vero è definito infatti al valore atteso dei punteggi che la persona otterrebbe attraverso un numero indefinito di misurazioni equivalenti.
Una bassa affidabilità test–retest indica quindi che il punteggio osservato può dipendere in misura rilevante dalla specifica occasione in cui è stato rilevato. Di conseguenza, anche quando il test viene somministrato una sola volta, il punteggio osservato può rappresentare con scarsa precisione la caratteristica stabile che si intende misurare.
L’affidabilità test–retest viene spesso quantificata mediante il coefficiente di correlazione tra i punteggi al test e al retest oppure mediante un coefficiente di correlazione intraclasse (intraclass correlation coefficient, ICC).
Il coefficiente di correlazione esprime principalmente la consistenza relativa tra le due misurazioni, ossia il grado in cui le persone mantengono un ordinamento simile nelle due occasioni. Una correlazione può quindi essere molto elevata anche quando i punteggi al retest sono sistematicamente più alti, per esempio a causa di un effetto pratica. Per questo motivo, quando l’affidabilità test–retest è espressa mediante una correlazione, il coefficiente dovrebbe essere accompagnato dall’analisi di eventuali cambiamenti sistematici tra le due somministrazioni, per esempio attraverso il confronto tra le medie e l’esame della distribuzione delle differenze (es. Arcara & Bambini, 2016).
La ICC non è un singolo coefficiente, ma una famiglia di coefficienti. Quelle più pertinenti nel caso dell’affidabilità test–retest sono le ICC basate sull’accordo assoluto, che tengono conto delle differenze sistematiche tra test e retest e sono quindi più sensibili alla presenza di un effetto pratica.
Nel tipico disegno test–retest, nel quale le due occasioni sono prestabilite e (approssimativamente) identiche per tutti i partecipanti, viene generalmente raccomandato un modello a due vie, a effetti misti, basato sull’accordo assoluto e riferito a una singola misurazione13. (Shrout & Fleiss, 1979; McGraw & Wong, 1996; Koo & Li, 2016). Per un approfondimento sull’affidabilità test–retest, sull’effetto pratica e sulle differenze tra correlazione e ICC, si veda la Parte II – Approfondimenti tecnici.
Soglie indicative: non esiste una soglia universalmente valida. Un coefficiente pari o superiore a 0.70 viene talvolta considerato un requisito minimo per finalità di ricerca o per confronti tra gruppi. Quando il punteggio contribuisce a decisioni importanti sul singolo individuo, sono generalmente richiesti valori più elevati: spesso almeno 0.90 e, idealmente, circa 0.95 (Nunnally & Bernstein, 1994).
2.6.1.4 Inter-rater agreement
L’accordo tra valutatori (inter-rater agreement o affidabilità inter-rater) misura quanto sia consistente il punteggio assegnato da valutatori diversi che osservano la stessa prestazione. È particolarmente rilevante per i test in cui il punteggio dipende da un giudizio qualitativo dell’esaminatore su una risposta che non è univoca (es. test in cui si deve dare una risposta soddisfacente ad un item, ma ci sono varie risposte che possono essere considerate soddisfacenti) oppure c’è una scala nella correttezza della risposta (es. 0 = errato, 1 = parzialmente corretto, 2 = corretto). In entrambi questi scenari aumentano le probabilità di discrepanza di punteggio date da diversi valutatori. Sono esempi di test in cui l’inter-rater agreement può essere tendenzialmente più basso i test di disegno, compiti di descrizione, oppure compiti di interpretazione di proverbi. L’inter-rater agreement è invece tendenzialmente più alto nei test in cui la risposta corretta è univoca (es. la parola da ricordare), in cui il punteggio di ciascun item è codificato su una serie di scelte dicotomiche (es. giusto/sbagliato). L’inter-rater è quindi tendenzialmente più alto in test come il digit span o compiti di memoria.
Esistono diversi modi per assicurarsi un buon inter-rater agreement sia più alta e tutte sono legate alla procedure utilizzate nel test. Abbiamo già visto due elementi chiave: la complessità del comportamento da codificare e il range dei punteggi da attribuire ad ogni singola prova. Entrambi, tendenzialmente, influenzano come sarà la affidabilità inter-rater finale. Esiste però un altro elemento cruciale, e trasversale ad ogni tipo di test, ed è la chiarezza nelle procedure di attribuzione dei punteggi. Un buon test dovrebbe spiegare con estrema precisione quali le regole di attribuzione e anche spiegare come comportarsi nei casi ambigui. Anche in test in cui potrebbe sembrare poco rilevante, infatti l’inter-rater agreement può essere migliorata da regole chiare nel dare i punteggi. Supponiamo per esempio che si stia utilizzando una semplice prova di lettura di parole, in cui si attribuisce un punteggio di 1 se la parola è letta correttamente e di 0 se la parola è letta con uno o più errori. Potrebbe sembrare una situazione semplice in grado di garantire un alta inter-rater agreement. Immaginiamo ora che una persona legga una parola solo in parte, si fermi, e ricominci a leggerla dall’inizio. Questa sarebbe da considerare come un errore o una risposta corretta? Oppure immaginiamo una persona che legga una parola in maniera esageratamente lenta, è da considerare un errore o una risposta corretta? Non esiste una risposta generalmente giusta su come trattare questi due esempi: tutto dipende da come è stato costruito il test e su quale è stata l’esatta procedura di attribuzione di punteggi utilizzata dallo sviluppatore del test. Ne consegue che quanto più questa procedura di attribuzione è esplicitata chiaramente, quanto più diversi valutatori convergeranno nel dare gli stessi punteggi in queste situazioni.
L’inter-rater agreement è, praticamente per definizione, strettamente collegato al concetto di oggettività del test, cioè l’indipendenza dei risultati dall’osservatore (vedi Misurazione e test in neuropsicologia clinica, e Focus: i test sono veramente oggettivi.
L’Inter-rater agreement si esprime tipicamente tramite l’Intraclass Correlation Coefficient (ICC) che, come anticipato nel precedente paragrafo, tiene conto anche dell’accordo assoluto tra i valutatori (cioè assume valori alti solo se i valutatori assegnano più o meno lo stesso punteggio), e non solo di quanto i loro punteggi sono consistenti (Fastenau et al., 1996, citati in Slick, cap. 1 in Spreen & Strauss, 2006). Più specificamente, nei tipici disegni sperimentali usati per definire la affidabilità inter-rater, andrebbe usato un modello analogo a quello già specificato per affidabilità test–retest (Shrout & Fleiss, 1979; Koo & Li, 2016). Si veda il paragrafo su Intra-class correlation della Parte II – Approfondimenti tecnici per ulteriori dettagli.
Soglie indicative: Secondo Cicchetti & Sparrow, 1981 (citati in Slick, cap. 1 in Spreen & Strauss, 2006) i valori di ICC dovrebbero essere interpretati come segue: inferiori a 0.40 scarsi, tra 0.40 e 0.59 discreti, tra 0.60 e 0.74 buoni, pari o superiori a 0.75 eccellenti. Con una classificazione lievemente diversa, Fastenau et al. (1996) considerano 0.60 come soglia per un accordo “sostanziale” e 0.75-0.80 per un accordo “quasi perfetto”.
2.7 Affidabilità: riassunto
Abbiamo esaminato diversi tipi di Affidabilità, che secondo gli Standards è un principio unitario, ma che di fatto è analizzata, specie nel contesto della Teoria Classica dei Test, secondo gli specifici tipi di affidabilità esaminati. La tabella di seguito riassume i tipi di affidabilità e i principi base per valutarli.
Tabella riassuntiva Affidabilità:
| Tipo di affidabilità | Come si valuta | Soglia indicativa | Fonte |
|---|---|---|---|
| Consistenza interna | Alpha di Cronbach, Omega di McDonald | ≥ 0.70 (buono ≥ 0.80; in neuropsicologia spesso ~0.60) | Cicchetti et al., 1990; Sattler, 2001 |
| Test–retest | Correlazione o ICC | ≥ 0.70 (valutazione individuale ≥ 0.80) | Andrews et al., 1994; Sattler, 2001 |
| Split-half | Correlazione + correzione di Spearman-Brown | ≥ 0.70-0.80 | Slick, cap. 1 in Spreen & Strauss, 2006 |
| Inter-rater | ICC | ≥ 0.60 buono; ≥ 0.75 eccellente | Cicchetti & Sparrow, 1981; Fastenau et al., 1996 |
2.8 Capitolo 2: Riassunto
In questo capitolo sono state approfondite validità e affidabilità, due qualità fondamentali dei test neuropsicologici. La validità può essere definita, sommariamente, come la qualità di un test di misurare ciò che intende misurare, mentre l’affidabilità la precisione di un test. Abbiamo visto come la validità sia oggi concepita come un concetto unitario, sostenuto da diverse fonti di evidenza piuttosto che da tipi distinti e indipendenti: evidenze basate sul contenuto del test, sui processi di risposta, sulla struttura interna, sulle relazioni con altre variabili (che comprendono quelle che tradizionalmente erano chiamate validità di costrutto, di criterio - concorrente e predittiva - ed ecologica) e sulle conseguenze del testing. Le etichette classiche restano un vocabolario utile e sono state mantenute nel capitolo, ricollocate all’interno di questa cornice più aggiornata. La validità di facciata, pur storicamente citata tra i tipi di validità, è stata trattata a parte, come concetto storico superato, ma non come evidenza tecnica di validità. Per l’affidabilità, il capitolo ha invece mantenuto la terminologia classica della Teoria Classica dei Test, distinguendone le principali declinazioni: l’affidabilità split-half (il confronto tra i punteggi di due metà dello stesso test), la consistenza interna (l’approccio più diffuso in pratica, stimato tipicamente con l’alpha di Cronbach o l’omega di McDonald), l’affidabilità test–retest (la stabilità dei punteggi tra due somministrazioni successive) e l’inter-rater agreement (la concordanza tra valutatori diversi). In generale sarebbe preferibile sempre scegliere test che abbiano buone (o quantomeno migliori in termini comparativi) evidenze di validità e affidabilità.
2.9  Nella pratica clinica: come usare validità e affidabilità per scegliere i test
Una domanda che una/un neuropsicologa/o dovrebbe porsi prima di utilizzare un test è: il mio test ha validità e affidabilità adeguate?
Immaginando di voler fare una valutazione neuropsicologica di alta qualità, questa dipende anche dallo scegliere strumenti di alta qualità. Parte della qualità di un test sono appunto la validità e affidabilità, tema di questo capitolo. Ma come farlo nel concreto? Bisogna semplicemente recuperare le informazioni rilevanti e valutarle.
Consiglio
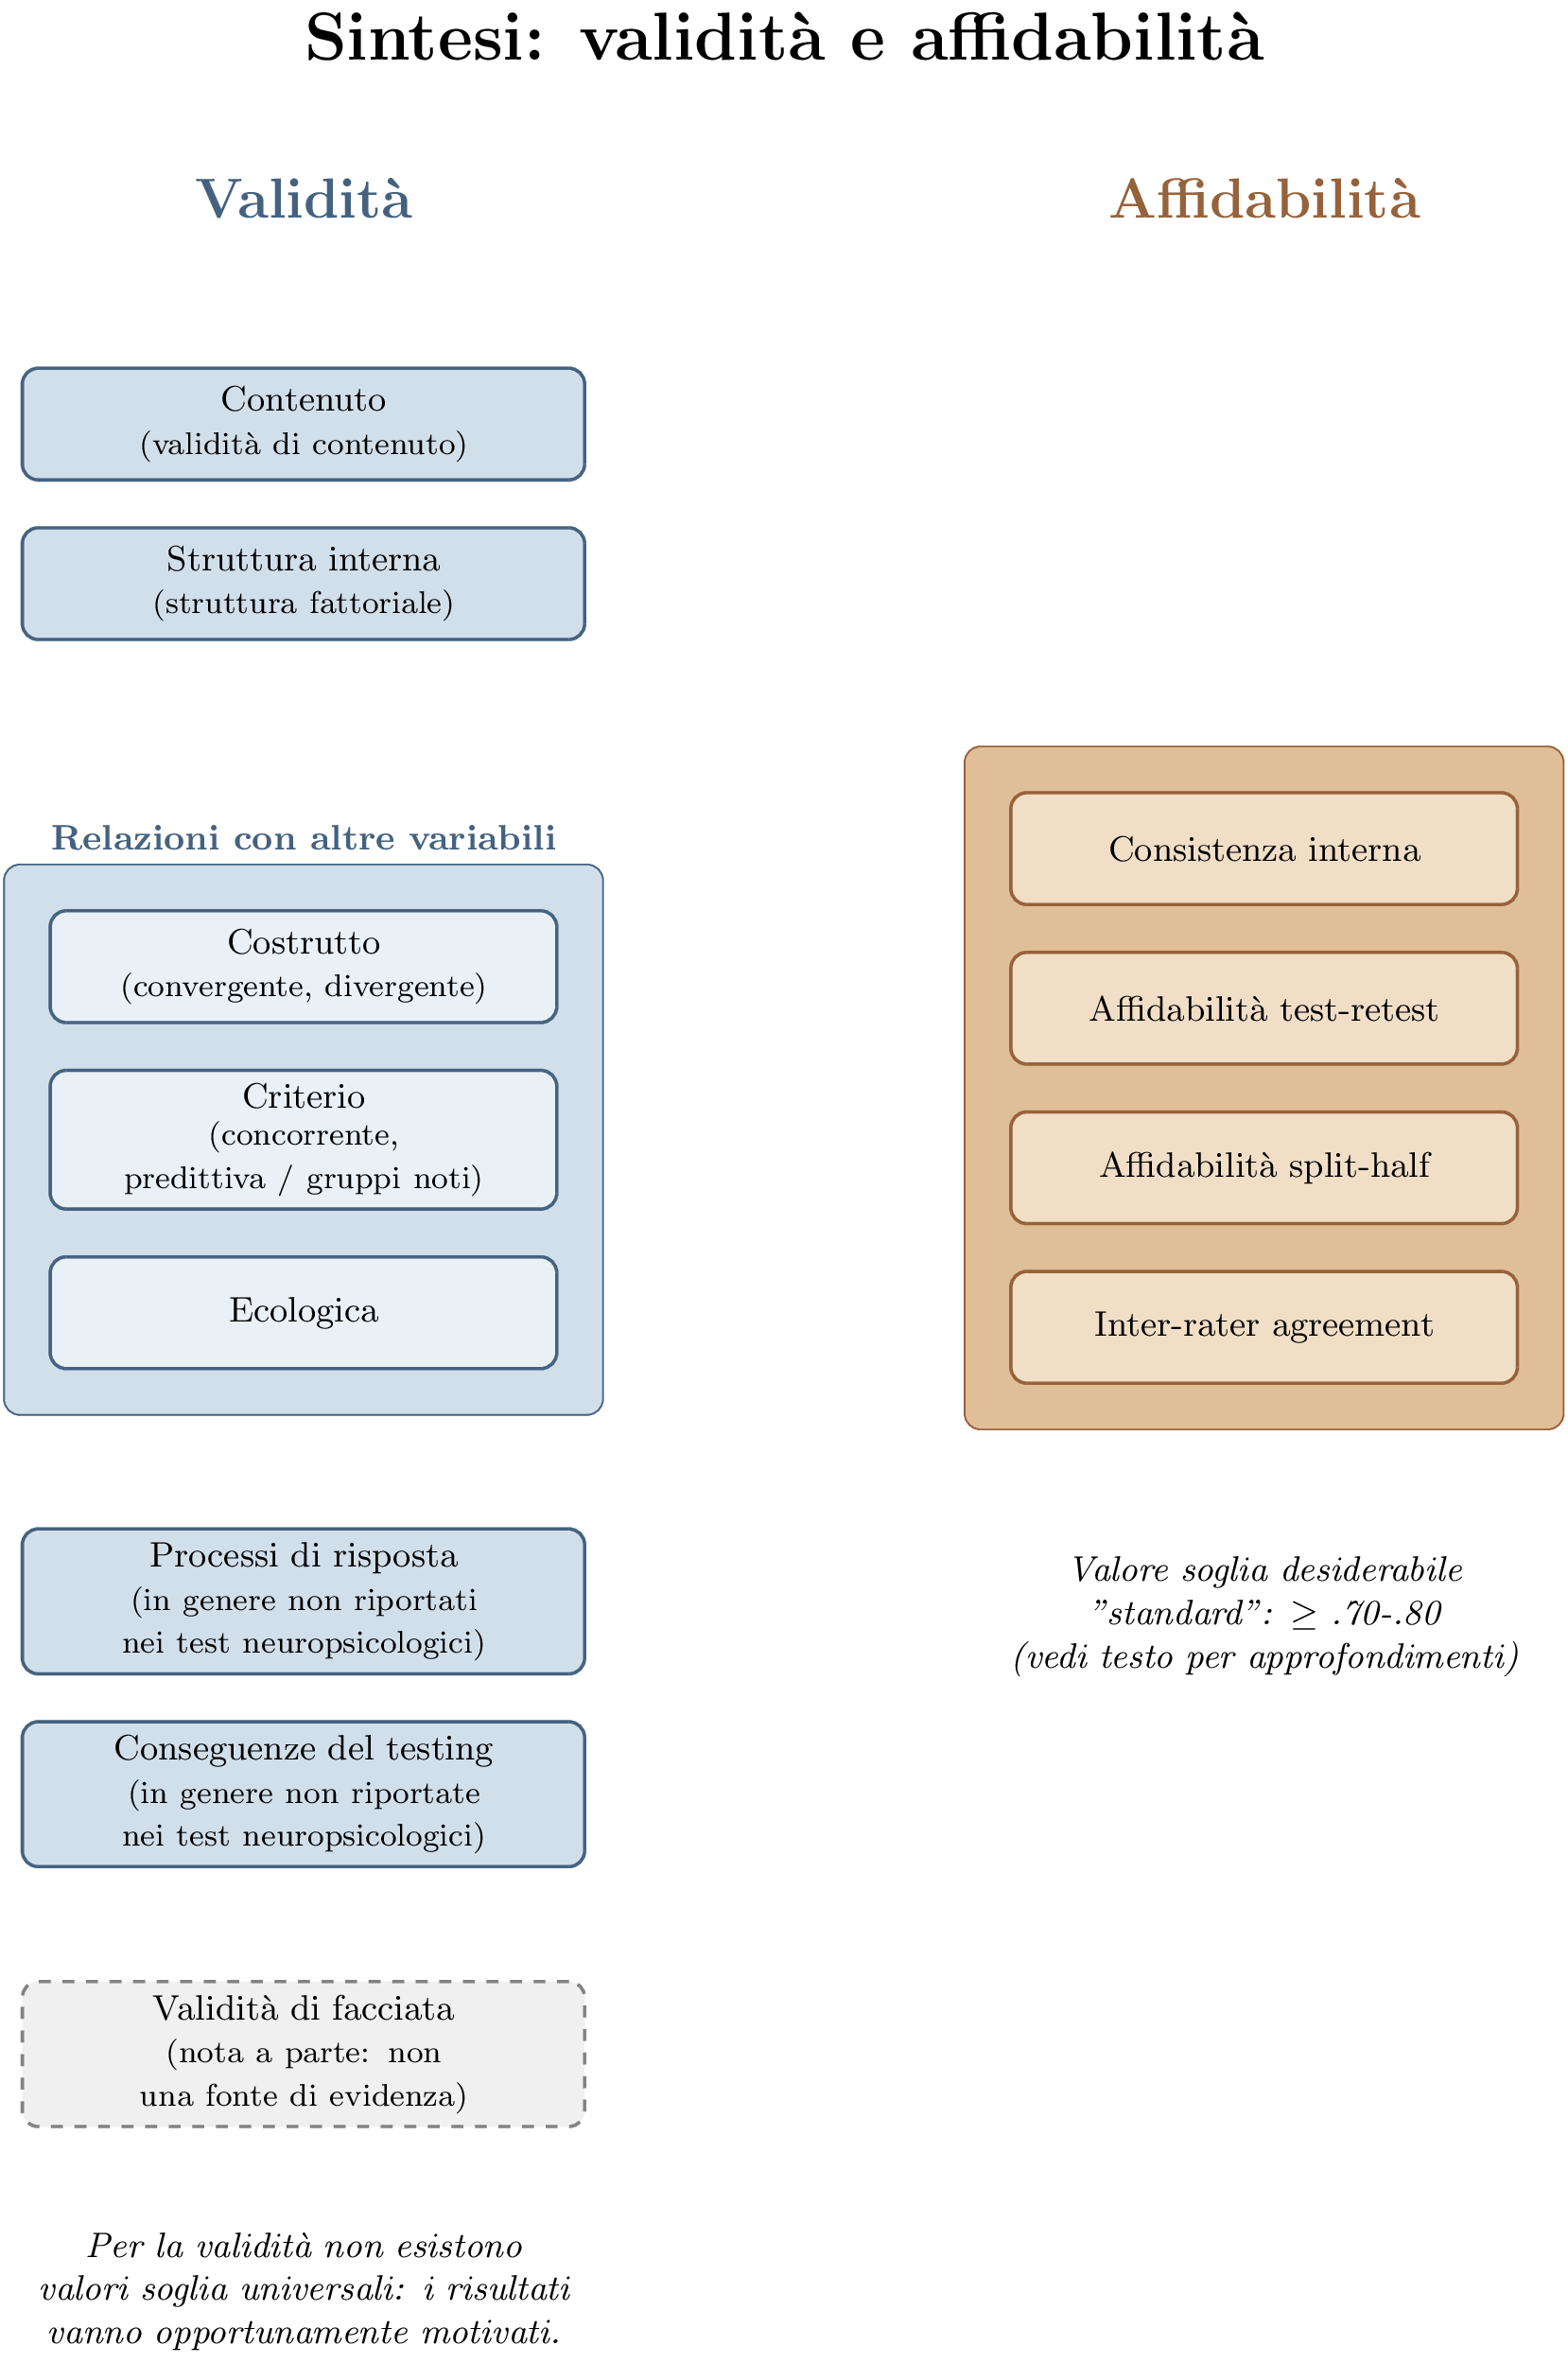
Un modo semplice per verificare affidabilità e validità di un test e scorrere il manuale o articolo del test e usare la lista di validità e affidabilità in Tabella 2.1 e in Tabella 2.3, oppure nella Figura 2.2. A partire da queste è possibile verificare innanzitutto se ci sono evidenze per le tipologie di validità ed affidabilità rilevanti per il test e per l’utilizzo che se ne vuole fare. Già l’assenza di dati su validità e affidabilità è di per sé un’informazione. Per quei valori che sono disponibili con opportuna cautela può essere valutato se i valori sono sufficienti oppure possono essere confrontati con quelli di alti test.
Quando si parla di valutazione di validità e affidabilità non si deve immaginare però una semplice lettura dei nomi il e confronto con una checklist. In accordo con lo spirito degli Standards for Educational and Psychological Testing (AERA, APA, & NCME, 2014), il/la professionista dovrebbe utilizzare il proprio giudizio critico per valutare se le evidenze fornite sono adeguate e sufficienti per gli scopi per i quali vuole utilizzare il test. Questo è anche lo spirito con cui gli Standards trattano le evidenze basate sulle conseguenze del testing, discusse in apertura della sezione sulla validità: la responsabilità di un uso appropriato del test è condivisa tra chi lo sviluppa e chi lo utilizza nella pratica. Ogni test ha le sue caratteristiche ed è difficile, se non impossibile, pensare ad una lista esaustiva che copra tutte le possibilità.
L’elenco delle tipologie di validità e affidabilità fornite in questo capitolo forniscono semplicemente un’aiuto per ricordare quali aspetti bisogno approfondire e su quali sono valori - indicativi - desiderabili per giudicare la bontà del test. Resta però una responsabilità del/della professionista approfondire se effettivamente questi valori sono pertinenti e se le evidenze riportate sono adeguate.
La strategia però che si può utilizzare è semplice ed è cercare di studiare il test per capire le risposte rispetto a queste due domande principali:
per la validità: il test fornisce evidenze sufficienti a motivare l’interpretazione che verrà fatta nella pratica clinica?
per l’affidabilità: il test fornisce evidenze sufficienti sulla sua precisione?
Il primo posto in cui cercare validità e affidabilità è all’interno del manuale del test oppure, se pertinente, nell’articolo scientifico originale con cui lo strumento è stato presentato: è lì che dovrebbero trovarsi le evidenze di validità e affidabilità raccolte dagli autori al momento della pubblicazione. Le evidenze non si esauriscono però con la prima pubblicazione: un test può accumulare nuove prove di validità e affidabilità anche molti anni dopo la sua uscita, tramite nuove pubblicazioni o addendum. Per esempio, la Frontal Assessment Battery (FAB), pubblicata da Appollonio et al. (Appollonio et al., 2005), ha visto pubblicare nuove evidenze psicometriche in Aiello et al. (Aiello et al., 2022), quasi vent’anni dopo. Vale quindi la pena cercare, oltre all’articolo originale, anche altri studi successivi che lo citano (per esempio tramite Google Scholar o PubMed) e che ne approfondiscono le proprietà psicometriche, per verificare se sono emerse nuove evidenze in popolazioni o contesti diversi. È da notare che non è raro che alcune proprietà psicometriche non siano presentate proprio perché si dà per scontato che essa sia stata dimostrata in precedenti lavori con frasi del tipo “il test \(X\), è noto avere buona validità e affidabilità”. In tal caso, per volere fare un analisi approfondita, bisognerebbe però assicurarsi che il test per cui c’è evidenza di validità sia esattamente lo stesso che stiamo valutando: aveva esattamente gli stessi item? era sviluppato nella stessa lingua? con le stesse istruzioni? Un test che assume la propria validità o affidabilità sulla base di informazioni ed evidenze vaghe o remote dovrebbe essere considerato come un test in cui le evidenze sono, almeno per questi aspetti, scarse.
Il fatto che un test sia pubblicato non garantisce che abbia validità e affidabilità sufficienti.
Uno strumento pubblicato potrebbe comunque avere una bassa validità (o non nota), e lo stesso vale per l’affidabilità. Questo vale indipendentemente dall’autorevolezza degli autori.
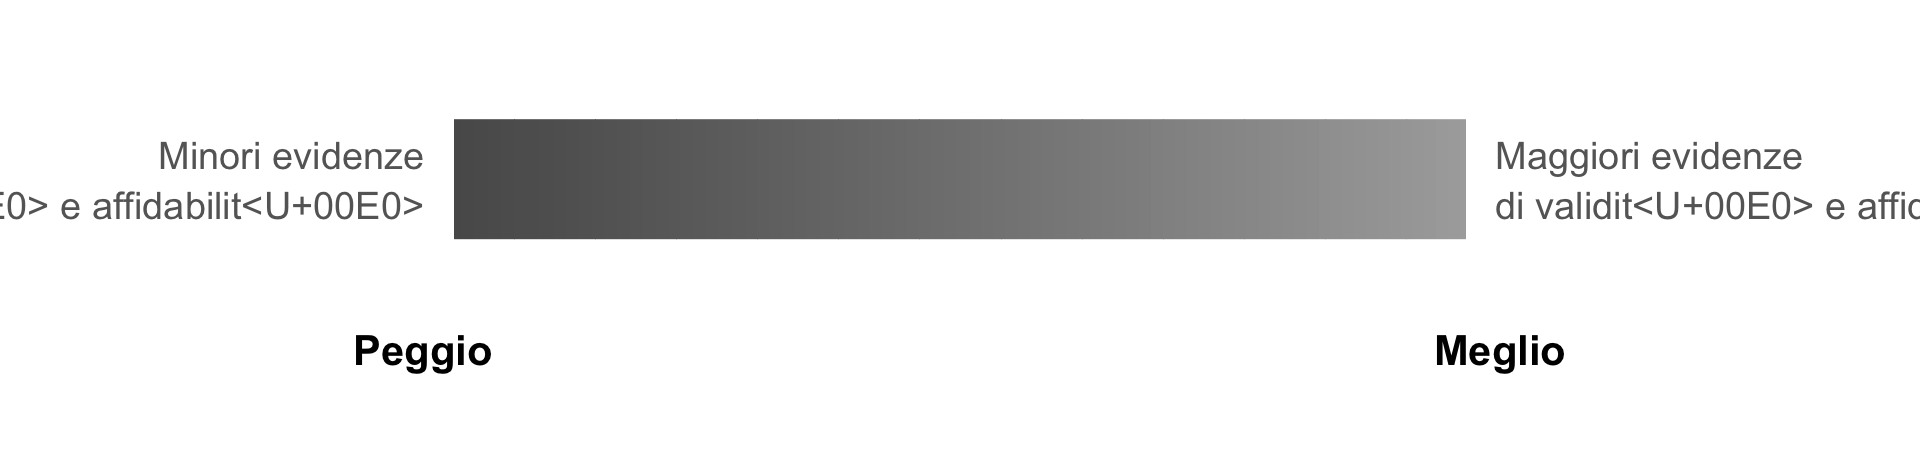
Come già sottolineato all’inizio di questa sezione, le evidenze di validità e affidabilità si accumulano nel tempo, e vanno considerate come all’interno di un continuum. Ci sono test con migliore validità e test con peggiore validità. Il fatto che informazioni su affidabilità o validità non siano disponibile non significa necessariamente che siano scarse, ma segnalano l’importante fatto che non le conosciamo e non siamo quindi in grado di giudicare se quel test è adeguato o no. Per tale motivo, scegliere di usare test senza che queste evidenze siano note andrebbe visto come muoversi verso il polo peggiore del continuum della Figura 2.3.
Purtroppo, potrebbe capitare che per alcuni test dati di validità e affidabilità non siano disponibili e siano disponibili, ad esempio, solo i dati normativi (si veda il Capitolo 3). Questi test andrebbero utilizzati con molta cautela, dal momento che in sostanza ci stiamo solo basando sulla loro apparenza (e quindi sul concetto obsoleto di validità di facciata) per stabilire se sono adeguati, e non abbiamo evidenze se effettivamente siano sufficientemente credibli. Di nuovo, l’approccio che suggerisco in questa sede è pragmatico e si basa su una scelta comparativa tra test.
Per fornire un esempio pratico, se siete interessati in un test di memoria (in particolare di recupero libero o su suggerimento), per il test Free and Cued Selective Reminding Test sono state pubblicate evidenza su consistenza interna e di validità (Clerici et al., 2017), e sarebbe da preferire rispetto ad altri test che misurano lo stesso costrutto ma non forniscono evidenze di questo tipo.
È anche per questo motivo che l’aggiornamento professionale è così rilevante in ambito neuropsicologico: nuove evidenze pubblicate nel tempo possono spostare la valutazione complessiva di uno strumento, in meglio o in peggio, verso una scelta più consapevolezza degli strumenti da mettere nella propria cassetta degli attrezzi.
Una domanda che potrebbe sorgere è: come fare nei casi in cui questa valutazione comparativa non sia così chiara? Potrebbe per esempio capitare di confrontare due test in cui in uno è migliore la validità mentre in un altro l’affidabilità. Questi casi sono trattati più estesamente nel capitolo Scegliere i test neuropsicologici in cui sono tenuti in considerazione anche gli altri elementi fondamentali per selezionare un test da utilizzare nella pratica clinica.
2.10  Focus: imprecisione dei test e intervalli di confidenza.
Le stime di affidabilità consentono di quantificare e comunicare l’incertezza associata a una misurazione. Un modo intuitivo per rappresentarla consiste nell’affiancare al punteggio osservato una fascia di valori plausibili, delimitata da un limite inferiore e uno superiore. Quanto più questa fascia è ampia, tanto maggiore è l’incertezza che circonda il punteggio.
Immaginiamo, per esempio, che un paziente ottenga un punteggio di \(16\) a un test e che a questo risultato sia associato il seguente intervallo: \(16\ [13,19]\). Consideriamo ora lo stesso punteggio osservato, ma accompagnato da un intervallo più ampio: \(16\ [8,24]\). Sebbene la stima puntuale sia identica, i due risultati hanno implicazioni molto diverse. Nel secondo caso, la gamma dei valori plausibili è considerevolmente più estesa e le conclusioni dovrebbero quindi essere formulate con maggiore cautela. Ciò risulta particolarmente evidente quando l’intervallo include una soglia clinica (si veda il Capitolo 3).
Più tecnicamente, nell’ambito della Teoria Classica dei Test intervalli di questo tipo possono essere costruiti mediante l’errore standard di misurazione ( standard error of measurement, SEM), che dipende dall’affidabilità del test e dalla variabilità dei punteggi. Fissato un determinato livello di confidenza (tipicamente il 95%), il SEM permette di calcolare un intervallo di confidenza associato al punteggio osservato.
Sebbene l’esplicitazione dell’incertezza di misura sia considerata molto importante in psicometria, ho scelto di non approfondire ulteriormente questo argomento nella presente sezione perché nella pratica neuropsicologica non esiste una prassi generale e condivisa su come integrare sistematicamente questi intervalli nelle decisioni cliniche e nella formulazione delle conclusioni. Presentarli senza mostrare chiaramente come dovrebbero modificare l’interpretazione del risultato rischierebbe quindi di aggiungere informazioni formalmente corrette, ma di difficile applicazione pratica.
Lo Standard Error of Measurement (SEM) e gli intervalli di confidenza che possono essere costruiti a partire da esso sono trattati più estesamente nella Parte II – Approfondimenti tecnici.
2.11 Focus: validità e affidabilità come proprietà riferite ad un contesto.
Più volte in questo capitolo è stato affermato che validità e affidabilità sono proprietà riconducibili ad un test. La letteratura scientifica evidenzia però spesso come questa definizione rischia di veicolare un messaggio scorretto, e cioè che validità e affidabilità siano proprietà più generiche di quanto effettivamente siano.
Ogni volta che è dimostrata validità e affidabilità secondo una delle maniere che abbiamo esaminato nel corso di questo capitolo, questa si riferisce ad uno specifico contesto, che può essere una specifica popolazione clinica, uno specifico intervallo di tempo (per affidabilità test–retest) o in generale uno specifica situazione di utilizzo del test. Ogni volta che l’utilizzo del test si allontana dalla situazione in cui le informazioni di validità e affidabilità sono state ottenute, non è detto che validità e affidabilità siano le stesse.
Uno dei casi più classici è quello della popolazione di riferimento, utilizzando il test con campioni non rappresentativi (es. persone che non sono madrelingua nella lingua con cui è sviluppato il test), i valori potrebbero non essere gli stessi. Se il test ha comprovata validità in persone giovani, non è detto che l’abbia anche con anziani. Un caso specifico, e particolarmente rilevante, è quello noto come invarianza di misura, oggetto del prossimo paragrafo.
2.12 Focus: invarianza di misura nei test neuropsicologici
Un tema fondamentale della psicometria, che meriterebbe un capitolo a sé, è quello dell’ invarianza di misura.
Definizione
L’invarianza di misura è la proprietà che valuta se un test misuri lo stesso costrutto in maniera analoga in diversi gruppi, contesti o occasioni di somministrazione (Putnick & Bornstein, 2016).
In sostanza, quando c’è invarianza di misura riferita a diverse condizioni, la relazione tra il costrutto e le prestazioni osservate in queste condizioni rimane sufficientemente stabile da consentire dei confronti. Per esempio, un test di memoria utilizzato sia con persone sane sia con persone con malattia di Alzheimer presenta il livello di invarianza di misura necessario al confronto tra gruppi quando la relazione tra abilità di memoria (il costrutto sottostante) e le prestazioni osservate può essere considerato come analogo tra i due gruppi. Non ci si aspetta, naturalmente, che essi ottengano gli stessi punteggi nel test di memoria, ma che i punteggi abbiano un significato comparabile.
Anche l’invarianza non è una proprietà assoluta del test, ma deve essere valutata empiricamente rispetto a determinate popolazioni e nell’ambito di uno specifico modello di misura (es. Teoria Classica dei Test). Come al solito, è quindi più corretto parlare di evidenze a favore dell’invarianza che considerare un test come “invariante” in generale. Il livello di invarianza necessario dipende però dall’inferenza che si vuole formulare: riconoscere nei diversi gruppi la medesima struttura generale del costrutto richiede condizioni meno stringenti rispetto al confronto quantitativo dei punteggi o delle medie tra i gruppi.
In ambito neuropsicologico l’invarianza di misura è solo raramente studiata. Uno studio esemplificativo di Chang e Brainerd (Chang & Brainerd, 2021) sulla batteria neuropsicologica dell’ADNI mostra come questa condizione non possa essere data per scontata: gli autori hanno rilevato una invarianza nel tempo all’interno di ciascun gruppo, ma problemi di invarianza nei confronti tra gruppi.
Oltre alla mancanza di dati empirici specificamente sull’invarianza di misura, quest’ultima costituisce un tema particolarmente delicato per i test neuropsicologici per almeno due ragioni.
La prima è che per molti strumenti la struttura fattoriale di riferimento è stata ricavata prevalentemente da campioni normativi composti da persone sane, e non da campioni di persone con patologie o condizioni di interesse. Non è quindi possibile assumere automaticamente che il modello di misura e il significato dei punteggi rimangano invariati in condizioni cliniche.
La seconda ragione è che alcune condizioni rendono particolarmente plausibile già a priori la presenza di problemi di invarianza di misura. Si consideri, per esempio, il MoCA, uno strumento di screening cognitivo generale, quando è somministrato a persone con grave afasia (si veda anche il paragrafo Focus: utilizzare i punteggi ai test per comunicare lo stato clinico). Le richieste linguistiche di diversi compiti possono influenzare il risultato, facendo sì che il punteggio totale rifletta non soltanto il funzionamento cognitivo generale, ma anche le abilità di compromissione linguistica. Il problema può essere formulato propriamente in termini di invarianza, quando si verifica empiricamente se le prove funzionino in maniera sistematicamente diversa tra gruppi di persone con e senza afasia. Nella pratica clinica tuttavia, i problemi di invarianza come quello appena descritto vengono spesso affrontati attraverso l’interpretazione qualitativa della singola prestazione e le conoscenze teoriche della/del neuropsicologa/o, senza che siano necessariamente disponibili verifiche psicometriche formali.
L’argomento sarà ripreso nella Parte II – Approfondimenti tecnici, nel capitolo dedicato all’invarianza di misura.
2.13 Focus: dalla validità di un test alla validità di una specifica valutazione
Nel corso del capitolo si è più volte parlato, per semplicità, della validità come di una proprietà del test. Già nei due paragrafi (val-aff-cont?) e (invarianza-intro?) abbiamo visto come le proprietà di un test siano quantomeno di considerare come relative ad un contesto. Possiamo spingerci ancora oltre in questa elaborazione.
Immaginiamo di avere a disposizione un test di memoria con eccellenti proprietà psicometriche, alta validità e affidabilità, mostrate sia in persone sane, sia in pazienti con MCI. Immaginiamo di testare con questo test una persona con sospetto MCI. Il contesto ci suggerirebbe che è analogo a quello in cui è stato sviluppato il test, a sostegno quindi della pertinenza delle prove di validità.
Immaginiamo però che questo individuo sia fortemente oppositivo nei confronti della valutazione, e in particolare che decida di non impegnarsi nei compiti proposti perché scettico sulla loro utilità. Un eventuale punteggio basso non potrebbe essere interpretato con leggerezza come segnale di un problema nella memoria, perché la prestazione potrebbe riflettere soprattutto lo scarso coinvolgimento nella prova (nonostante le eccellenti proprietà del test). Ciò non annulla le evidenze di validità accumulate: indica, piuttosto, che le inferenze abitualmente tratte dai suoi punteggi non sono giustificate in quella specifica somministrazione. La qualità psicometrica dello strumento e l’interpretabilità dei dati ottenuti nel singolo caso sono quindi condizioni che è utile considerare come dissociabili.
Questa distinzione è comunemente tenuta in considerazione in neuropsicologia forense, ma è anche considerata importante in contesto clinico (sebbene non altrettanto diffusa). Il Performance Validity Testing (PVT) comprende procedure e indicatori volti a valutare se la prestazione osservata possa essere considerata una rappresentazione credibile delle capacità della persona esaminata. In ambito forense è rilevante nei casi in cui è verosimile che la persona stia deliberatamente simulando un deficit, per ottenere un vantaggio. Il Capitolo 7 è specificamente dedicato a queste procedure e al loro ruolo nella valutazione della simulazione in ambito forense. Il Capitolo 10 riprenderà in parte questi concetti in ambito più clinico e sarà dedicato in generale all’interpretazione dei test.
Questo tema si ricollega anche alle evidenze basate sulle conseguenze del testing, introdotte in apertura della sezione sulla validità: un punteggio ottenuto in condizioni non credibili non segnala necessariamente un problema di validità del test in sé, ma un problema di validità della specifica misurazione in cui è stato ottenuto.
2.14  Errori comuni: ignorare validità e affidabilità di un test.
Uno degli errori più comuni che ho riscontrato durante nella mia esperienza con studentesse, studenti e anche professioniste/i nell’ambito neuropsicologico clinico è quello di ignorare validità e affidabilità dei test neuropsicologici. Questa attitudine è accompagnata spesso da un’attenzione esclusivamente focalizzata sulla qualità dei dati normativi (si veda Capitolo 3). Alla mia domanda “conoscete affidabilità e validità dei vostri strumenti?”, la risposta è spesso: “no”14.
Questa pratica diffusa è a mio avviso rinforzata da una serie di intrinseche caratteristiche della letteratura scientifica legata ai test, specie della neuropsicologia dell’adulto e specie in Italia (si veda Aiello et al., 2022 per qualche considerazione). L’attenzione è più rivolta ad avere campioni normativi ampi e rappresentativi, o soglie calcolate con metodi sofisticati, ma raramente la domanda è: siamo certi che stiamo misurando ciò che vogliamo misurare? E con che precisione?
Considerare che i test siano tutti precisi allo stesso modo è però un’assunzione forte e pericolosa, oltre che ingiustificata. Significa assumere che il test nel suo punteggio totale stia misurando il costrutto di interesse senza una reale prova (assenza di prove di validità di costrutto), significa assumere che il test abbia tutti gli item appropriati senza una reale prova (assenza di prove di consistenza interna), significa assumere che il test sia relativamente stabile nel tempo (assenza di prove di affidabilità test–retest), e così via. Eppure evitare questo errore è relativamente semplice, basta considerare validità e affidabilità quando si seleziona un test (si veda par. Nella pratica clinica: Come usare validità e affidabilità per scegliere i test).
Non voglio però banalizzare questo problema: se in accordo allo “spirito del tempo” della neuropsicologia clinica non è data molta rilevanza a validità e affidabilità, una ragione probabilmente c’è e merita di essere indagata. È possibile identificare facilmente almeno due ragioni: la situazione da un lato riflette una generale poca attenzione alle proprietà psicometriche in psicologia (si veda Flake & Fried, 2020, per un’analisi sulla validità); la situazione probabilmente affonda le radici in quelli sono i principi - spesso impliciti - alla base della valutazione neuropsicologica e alla storia con cui la neuropsicologia clinica si è sviluppata. Questi aspetti sono trattati più in dettaglio nel Capitolo 11.
2.15 Focus: valutare la validità di costrutto
Uno degli aspetti più difficili da valutare è l’adeguatezza della validità di costrutto di un test neuropsicologico. Questo avviene perchè non esistono valori univoci che possono dirci se una correlazione è sufficientemente alta oppure no, oppure se una correlazione debole con un altro costrutto è un problema, oppure è perfettamente in linea con quello che ci si dovrebbe attendere dal test.
Supponiamo di sviluppare un test di memoria e di indagare la validità di costrutto tramite la correlazione con un altro test di memoria (validità convergente) e di controllare anche la correlazione con un altro test di ansia di stato, per cui ci si attende una bassa correlazione (validità divergente). Supponiamo di trovare che il test abbia una correlazione pari a 0.4 con l’altro test di memoria e di 0.22 con il test di ansia. Come interpretare questi valori? Sono evidenza di validità di costrutto oppure no? Il valore 0.4 è sufficientemente alto per dire che i test misurano lo stesso costrutto? E il valore di 0.22 è sufficientemente basso per dire che non lo stanno misurando? La risposta dipende largamente dai test coinvolti e quindi non è facile trovare criteri assoluti e indipendenti. Ad esempio, anche se 0.4 è una correlazione moderata, potrebbe essere perfettamente giustificabile considerando che i test di memoria sono piuttosto diversi tra loro. Oppure il valore di 0.22 potrebbe non essere eccessivamente alto considerato che ci si aspetta che l’ansia di stato possa influenzare la prestazione al test. Come già detto, è compito della/del neuropsicologa/o che vuole utilizzare il test interpretare criticamente questi dati che sono forniti con il test, valutando le argomentazioni portate dagli sviluppatori del test. Tali dati sono però particolarmente esposti al rischio di flessibilità interpretativa post-hoc: è facile, guardando i dati a posteriori, trovare una spiegazione plausibile per qualunque pattern di correlazioni osservato e motivarlo. Questo è particolarmente rilevante per tutti quei test in cui ci si attende correlazione con diversi costrutti o in cui il costrutto di interesse non è chiaramente esplicitato (vedi par.Relazioni con altre variabili coerenti con il costrutto).
Una possibilità promettente per risolvere questo problema è quello di “pre-registrare” i risultati attesi che sono considerati come soddisfacenti (Binney et al., 2025). Gli autori di un test con valutazione rigorosa della validità di costrutto dovrebbero effettuare una registrazione in un punto sicuro e pubblico (in genere un sito web dedicato alle pre-registrazioni) in cui sono riportati quali sono le attese e i range di valori considerati sufficienti per validità. Aspetto fondamentale, questa pre-registrazione dovrebbe avvenire prima ancora di raccogliere i dati: in questa maniera si può avere sicurezza che i valori ottenuti per la validità non sono stati interpretati post-hoc come adeguati, ma rientrano effettivamente tra le previsioni degli autori. Quello della pre-registrazione è uno strumento legato al movimento dell’ Open Science che sembra particolarmente utile per questo caso, ma ovviamente va considerato più come una raccomandazione o un suggerimento per chi costruisce o sviluppa i test per permetterne una valutazione più trasparente e non è detto sia presente nei test di nostro interesse.
2.16 Focus: chiarezza del costrutto o del criterio
La possibilità di valutare in maniera adeguata la validità di un test dipende anche dalla chiarezza del costrutto (o criterio) che si vuole misurare. Per quanto riguarda la validità di costrutto, questo diventa difficile se il costrutto è complesso (si veda il paragrafo Oggetti di interesse dei test neuropsicologici), ma soprattutto se il concetto è vago o legato ad una concezione teorica vaga. Un costrutto complesso infatti non è di per sé sbagliato o un problema, ma le analisi di validità di costrutto dovrebbero portare prove convincenti che il costrutto è misurato efficacemente. Ad esempio, supponiamo che un test si proponga di misurare la capacità di comunicare efficacemente, ma in cui non è definito cosa si intende per “comunicazione” e quale è la teoria di riferimento, come valutare se il test funziona efficacemente? Una persona con afasia e difficoltà di articolazione, ma in grado di fare anche discussioni complesse tramite strategie compensative, ha una buona capacità di comunicazione oppure no? Questo dipende certamente da cosa definiamo per “comunicazione” e quindi dalla chiarezza del costrutto. Per approfondimenti su come questo potrebbe essere fatto si veda di nuovo il par. Focus: valutare la validità di costrutto. Lo stesso principio per i test che si riferiscono ad un criterio. Anche in questi casi il criterio può essere più o meno chiaro e questo influisce la nostra capacità di valutare il test. Ad esempio, supponiamo che un test abbia come criterio distinguere MCI da soggetti sani, ma che sia vago nella definizione dei due gruppi. Esistono diverse definizioni e classificazioni di MCI, così come esistono diversi modi di intendere i soggetti sani (si veda il Capitolo 3) e questo influenza come possiamo valutare il test e anche come interpretiamo i risultati.
ad una riflessione attenta, questa definizione pone già un problema, perché il punteggio \(T\) non dipende solo dal costrutto misurato, ma anche dal test che si utilizza per misurarlo (ad es., un valore pari a \(10\) al test per indicare il costrutto è banalmente dipendente dal range di punteggi che si possono ottenere al test). Il punteggio \(T\) è quindi strettamente legato al modo in cui il costrutto è operazionalizzato dal test. (Borsboom, 2005).↩︎
Considerando che possono esistere più scopi, forse sarebbe più esatto usare il plurale e dire che le diverse validità sono più proprietà lungo diversi continuum.↩︎
Una distinzione che è talvolta riportata, è quella tra validità “a priori” (valutabile analizzando il contenuto del test prima ancora di raccoglierne dati) e “a posteriori” (che richiede invece dati empirici). Questa distinzione non è adottata in questo libro, per evitare di frammentare ulteriormente la classificazione dei diversi tipi di validità.↩︎
Il calcolo del CVR e del CVI sono trattati più in dettaglio nella Parte II – Approfondimenti tecnici.↩︎
mnem↩︎
La PCA, diversamente dall’analisi fattoriale, ha principalmente uno scopo di riduzione dei dati e non è equivalente all’analisi fattoriale quando l’obiettivo è formulare inferenze su costrutti latenti.↩︎
in questo caso, per evitare circolarità nelle analisi, sarebbe importante che l’analisi esplorativa e confermativa siano effettuate su campioni indipendenti.↩︎
La saturazione fattoriale (factor loading) è un coefficiente che esprime la forza e la direzione dell’associazione tra un indicatore e un fattore. In alcune soluzioni standardizzate può essere interpretata in modo simile a una correlazione, ma il suo significato preciso dipende dal modello di analisi fattoriale utilizzato.↩︎
Anche in questo caso la classificazione di diversi tipi di validità è variabile. In questa sede adottiamo la classificazione di Slick (Slick, cap. 1 in Spreen & Strauss, 2006), che considera di fatto la known-groups validity come parte della criterion validity.↩︎
La Teoria della Generalizzabilità e le stime di precisione basate su IRT sono trattate più in dettaglio nella Parte II – Approfondimenti tecnici.↩︎
La formula della correzione di Spearman-Brown è trattata più in dettaglio nella Parte II – Approfondimenti tecnici.↩︎
Dettagli su \(\alpha\) e \(\omega\) e le formule per calcolarli, sono trattate più in dettaglio nella Parte II – Approfondimenti tecnici.↩︎
spesso questo è definito come ICC(2,1) o ICC(A,1), si veda la Parte II – Approfondimenti tecnici.↩︎
A voler essere precisi, negli ultimi anni la situazione è decisamente migliorata e stanno aumentando le persone sensibili all’importanza di questi aspetti. Tuttavia, le persone attente ad affidabilità e validità rimangono una minoranza.↩︎